

En resumen;DR
|
Toda organización que maneja datos confidenciales se enfrenta a una realidad simple: un eslabón débil en la seguridad de los datos puede resultar en daños financieros, legales y de reputación masivos. Solo en 2024, las empresas de todo el mundo incurrieron en un costo promedio de violación de $4.45 millones, siendo los datos personales y financieros uno de los tipos de datos más frecuentemente atacados.
Lo que es aún más preocupante es que muchas de estas brechas no ocurrieron en sistemas de producción; sucedieron porque se expusieron datos sensibles en entornos no productivos, como desarrollo, pruebas o analítica.
Esto deja algo claro: proteger los datos sensibles en cada etapa de su ciclo de vida ya no se trata solo de cumplimiento; se trata de proteger tu negocio de un riesgo real y medible.
Al aplicar las técnicas correctas de enmascaramiento de datos, puedes asegurarte de que, incluso si se accede a los datos sin autorización, sigan siendo inútiles para los atacantes, sin dejar de servir a las necesidades del negocio.
En este blog, descubrirás seis mejores prácticas de enmascaramiento de datos, prácticas y aplicables, que pueden ayudar a tu organización a reducir la exposición, fortalecer la seguridad y cumplir con confianza los requisitos regulatorios.
La importancia del enmascaramiento de datos: por qué es importante para tu organización
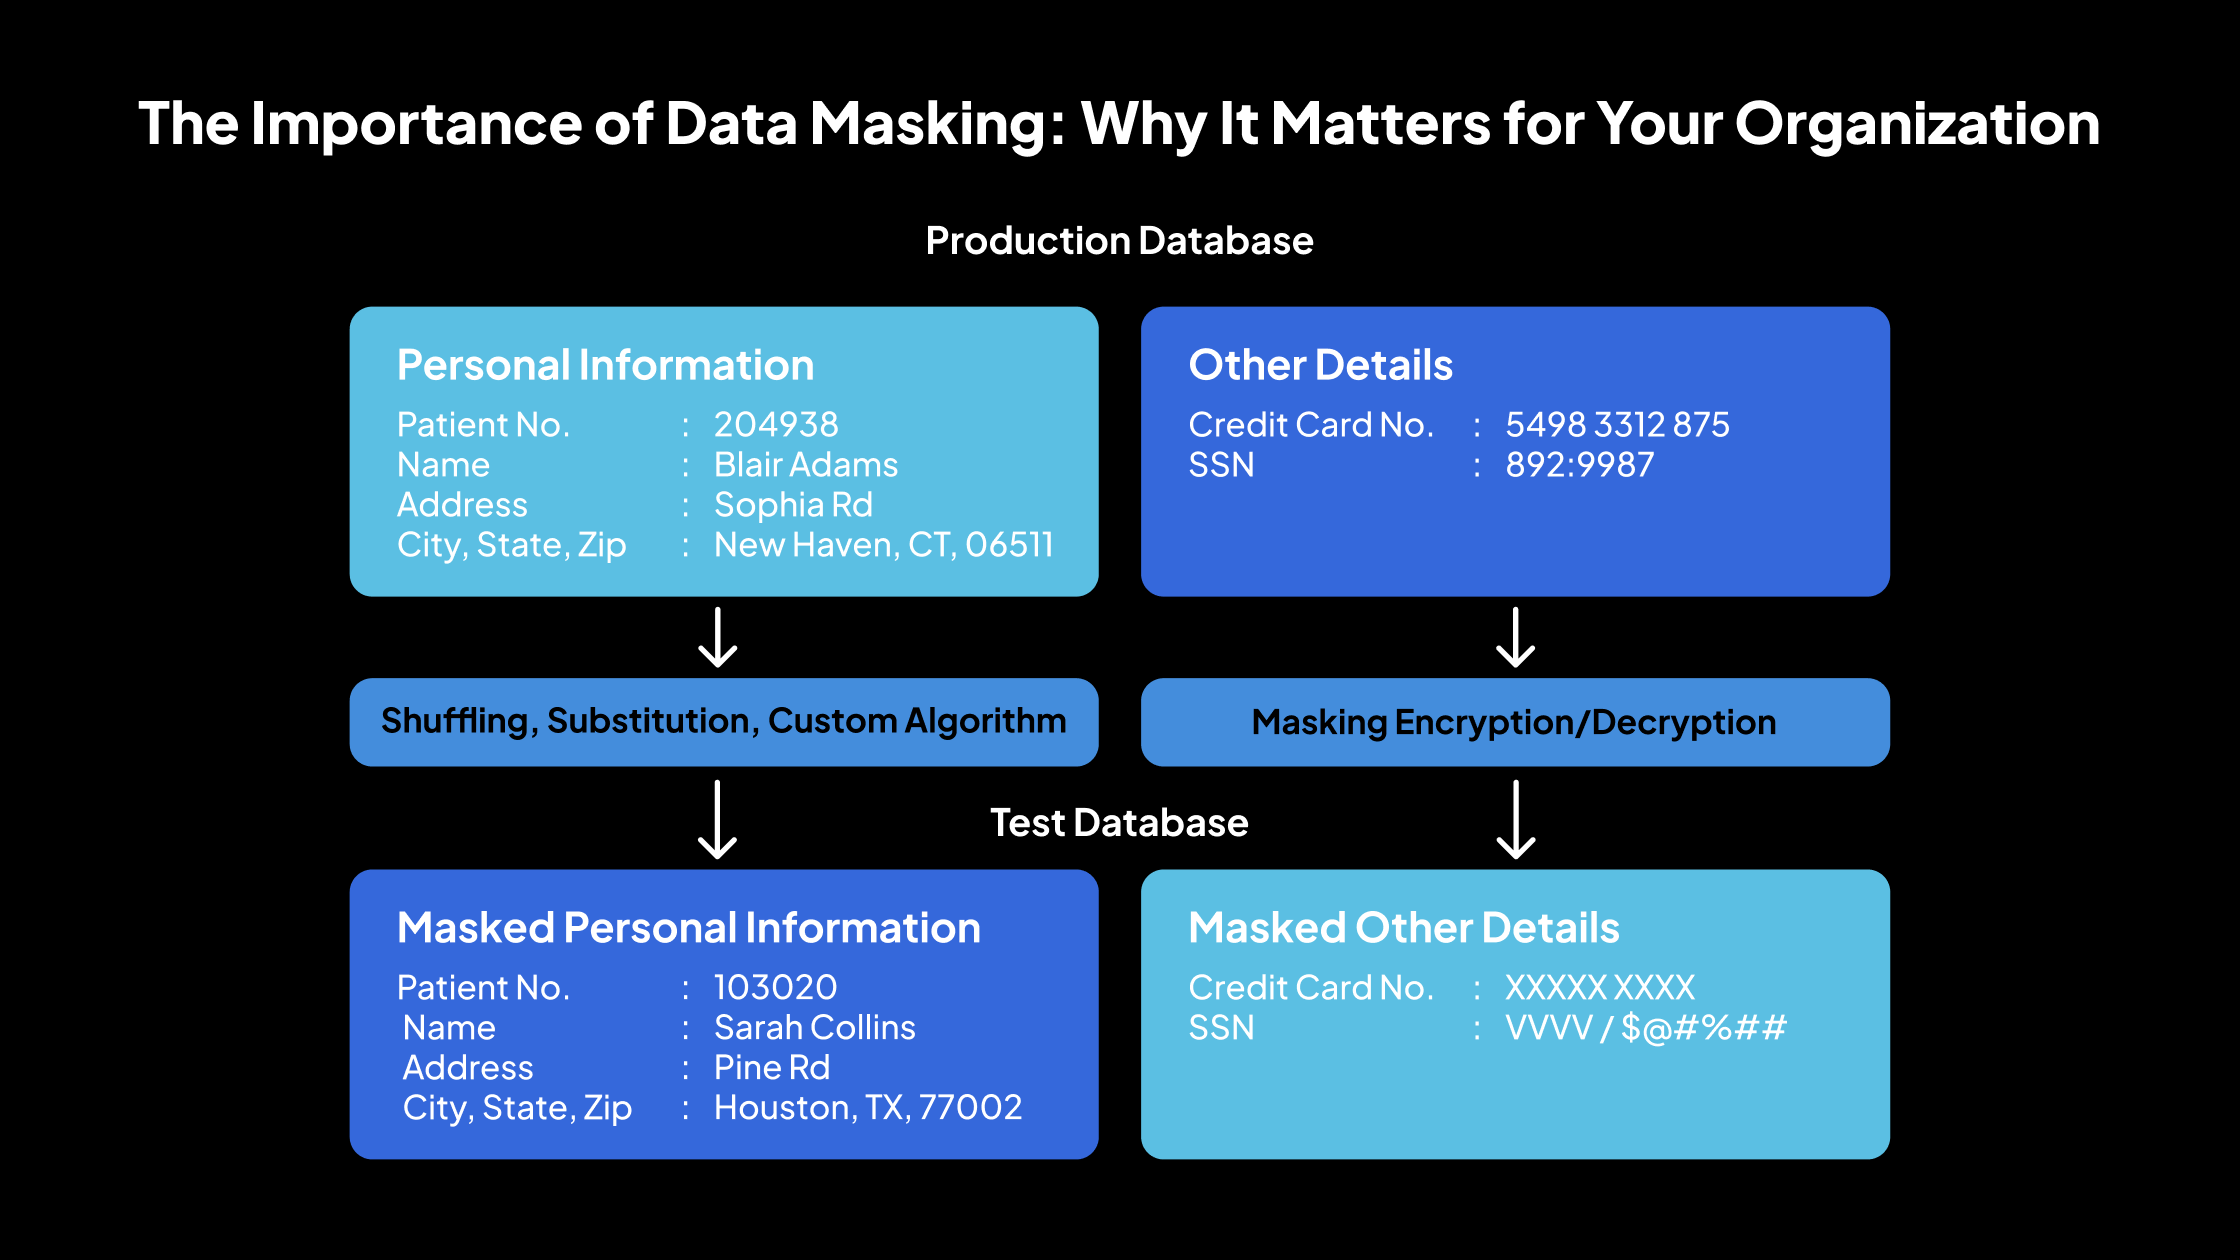
El enmascaramiento de datos es un método para sustituir información sensible por datos realistas, pero falsos. Se utiliza principalmente para proteger detalles confidenciales, manteniendo la utilidad de los datos para actividades fuera de producción, como pruebas de software, capacitación o demostraciones.
Los datos enmascarados conservan el mismo formato que el original, pero sus valores se alteran para que no puedan rastrearse ni revertirse para revelar la información real. Las técnicas estándar de enmascaramiento incluyen mezclar caracteres, sustituir palabras o números y usar cifrado. Por eso el enmascaramiento de datos es esencial:
Protege contra brechas de datos
El enmascaramiento de datos ayuda a proteger a las organizaciones de amenazas como la pérdida de datos, el acceso no autorizado y el uso indebido interno. Al enmascarar detalles sensibles, incluso si los datos se exponen durante un ataque, siguen siendo inutilizables para los ciberdelincuentes. El enmascaramiento reduce el riesgo de este impacto financiero al hacer que los datos no tengan sentido para los atacantes.
Seguridad en la nube
Muchas organizaciones están trasladando sus datos a entornos en la nube. El enmascaramiento de datos reduce los riesgos asociados con almacenar información sensible en la nube al garantizar que los datos expuestos o mal gestionados no puedan comprometer a la organización. Esto es especialmente importante, ya que 85% de las empresas ahora operan en entornos multinube.
Intercambio seguro de datos
Los datos enmascarados permiten a las empresas compartir información con usuarios autorizados, como desarrolladores, testers o analistas, sin revelar detalles reales de clientes o del negocio. Esto garantiza el cumplimiento de los estándares de privacidad, a la vez que impulsa el desarrollo y la innovación.
Cumplimiento normativo
El enmascaramiento de datos ayuda a cumplir con normativas de protección de datos, como el RGPD, la HIPAA y la CCPA. Estas leyes exigen que las organizaciones protejan los datos personales y sensibles. El enmascaramiento es una forma eficaz de cumplir con estas obligaciones legales durante actividades como pruebas y analítica.
Mejor sanitización de datos
La simple eliminación de archivos a menudo deja rastros de datos que pueden recuperarse. El enmascaramiento proporciona una capa adicional de protección al sobrescribir los valores originales con datos falsos, lo que hace mucho más difícil recuperar y usar indebidamente los datos eliminados.
-
Utilidad de los datos para pruebas y formación
Los datos enmascarados conservan la misma estructura y formato que el original, lo que permite usarlos en pruebas de software, capacitación de usuarios o entornos de demostración sin exponer información sensible. Esto garantiza escenarios realistas sin arriesgar fugas de datos.
6 Mejores prácticas de enmascaramiento de datos para el cumplimiento y la seguridad
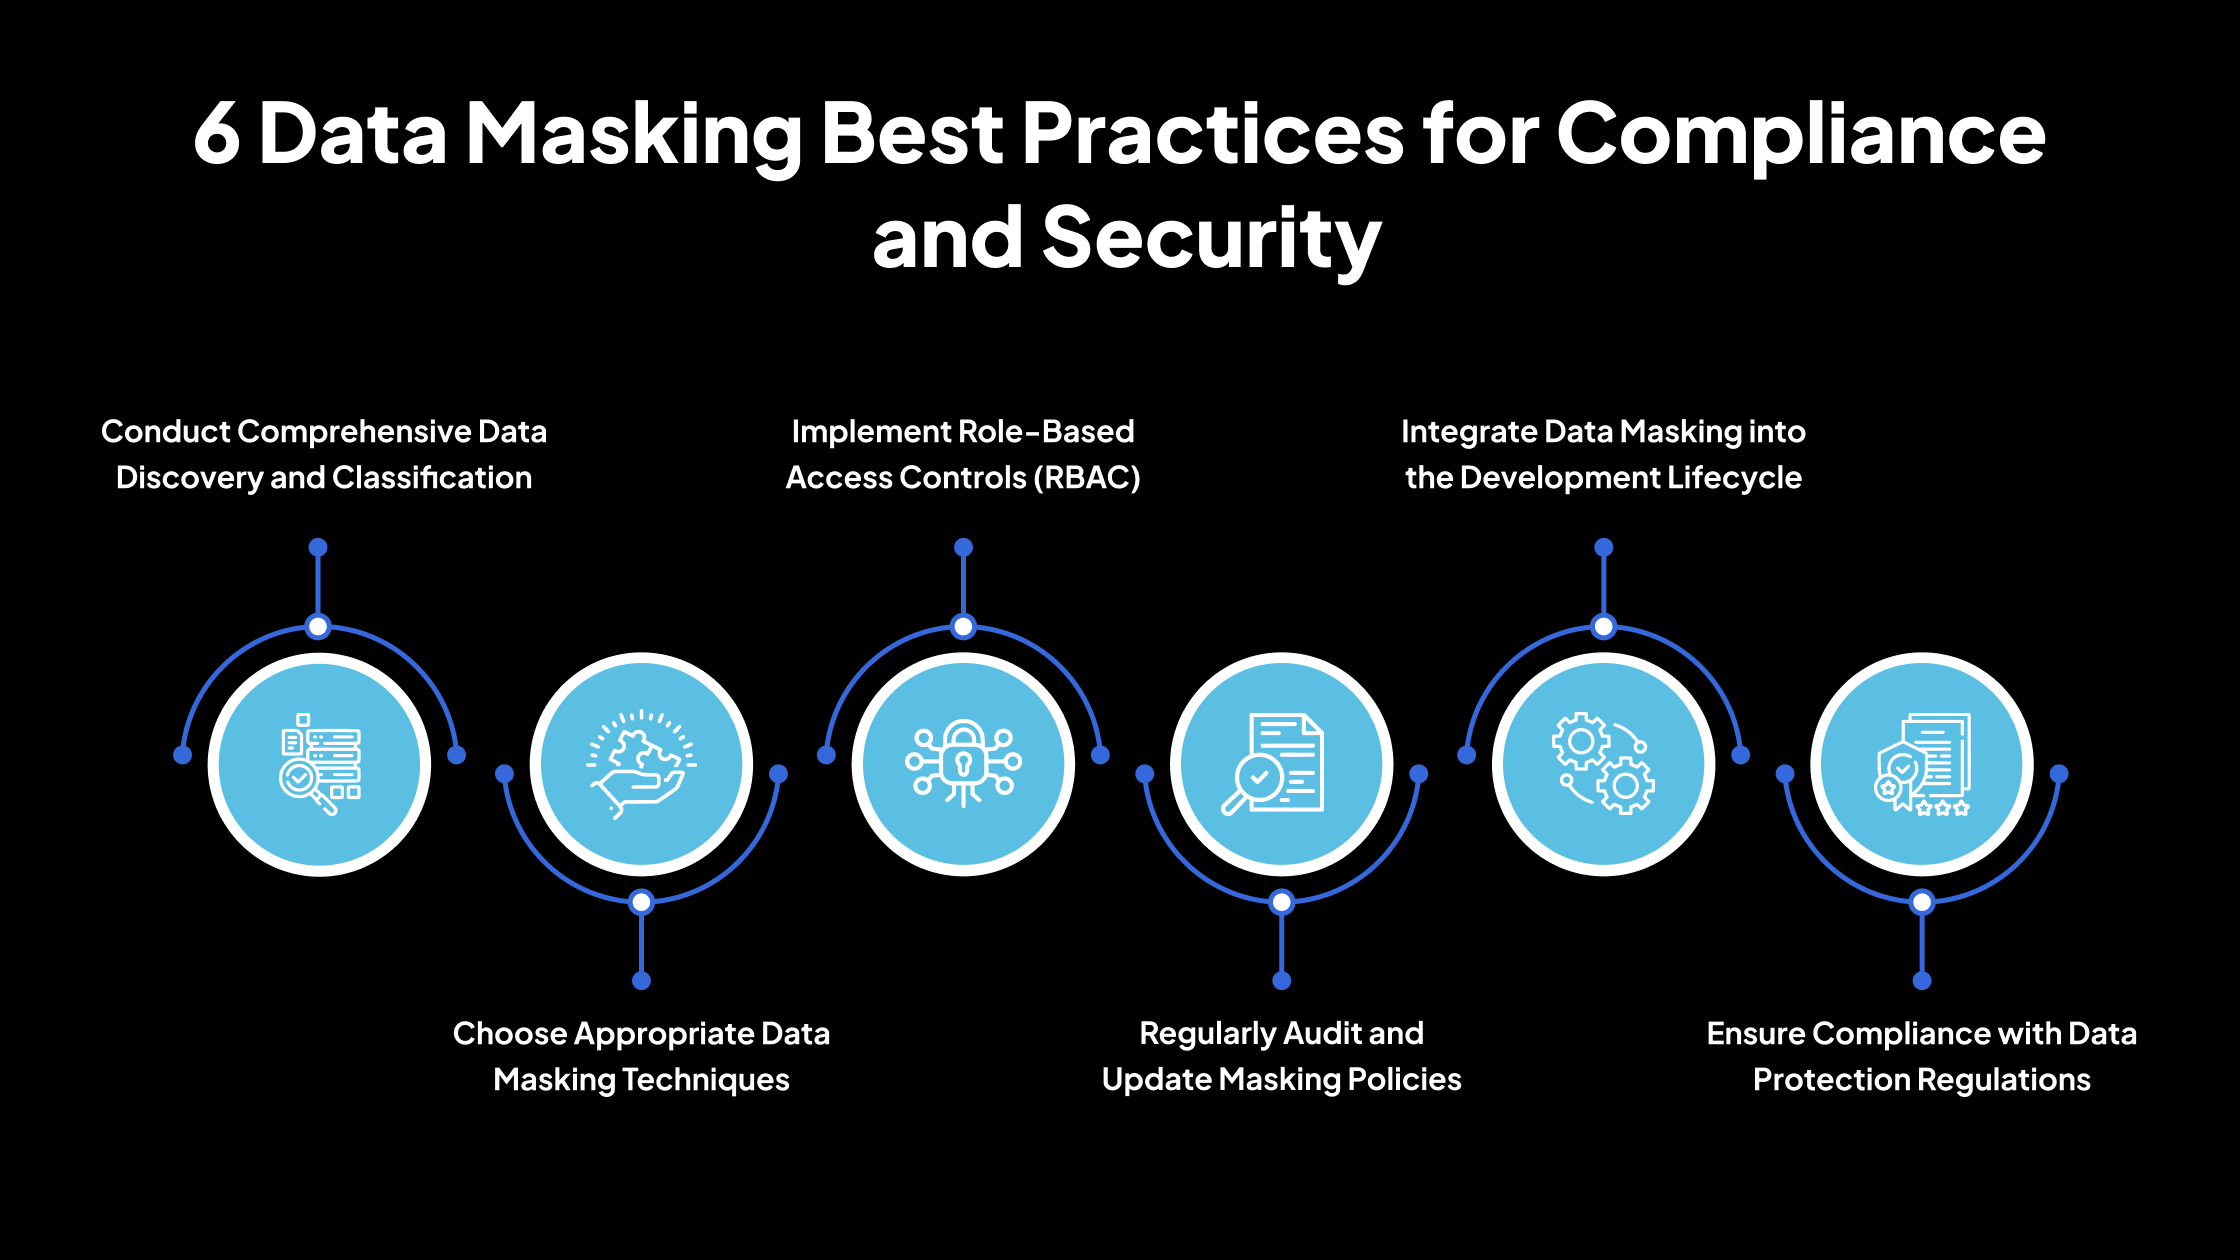
A continuación, se presentan seis mejores prácticas esenciales de enmascaramiento de datos que ayudan a proteger los datos sensibles, respaldar el cumplimiento y fortalecer la postura de seguridad de tu organización.
1. Realice un descubrimiento y clasificación de datos integrales
Una estrategia sólida de enmascaramiento de datos comienza por identificar exactamente qué datos requieren protección y dónde se almacenan. Sin esta base, los esfuerzos de enmascaramiento pueden pasar por alto datos críticos o aplicar enmascaramiento innecesario, lo que genera riesgos e ineficiencias.
Identifique los datos sensibles
El primer paso es localizar y comprender todos los datos sensibles que maneja tu organización. Esto incluye:
| Información de identificación personal (PII) | Información de salud protegida (PHI) | Datos financieros |
| Datos que pueden identificar a una persona, como nombres, direcciones, números de teléfono, números de seguro social y números de pasaporte. | Los historiales médicos, diagnósticos, detalles de tratamiento e información de seguros están cubiertos por normativas como la HIPAA. | Números de tarjetas de crédito, detalles de cuentas bancarias, historiales de transacciones y registros fiscales. |
Los datos sensibles pueden almacenarse en formatos estructurados (p. ej., bases de datos, data warehouses) o no estructurados (p. ej., documentos, correos electrónicos, hojas de cálculo). Es esencial mapear todas las ubicaciones donde residen estos datos, incluidos sistemas on-premise, entornos en la nube y plataformas de terceros.
No identificar repositorios de datos ocultos u olvidados es un riesgo de seguridad significativo. Un estudio del Ponemon Institute de 2023 encontró que 67% de las organizaciones tenían datos sensibles en ubicaciones que desconocían, lo que incrementa la exposición a brechas.
Utilice herramientas automatizadas
Dada la escala y complejidad de los entornos de TI modernos, el descubrimiento manual de datos es ineficiente y propenso a errores. Las organizaciones deben adoptar herramientas automatizadas de descubrimiento y clasificación de datos que utilicen tecnologías como:
- Coincidencia de patrones (p. ej., detectar formatos de números de tarjetas de crédito o números de seguro social)
- Modelos de aprendizaje automático e IA para reconocer tipos de datos en diversos sistemas
- Escaneo de metadatos para evaluar propiedades de archivos y esquemas de bases de datos
Estas herramientas pueden escanear grandes volúmenes de datos, identificar elementos sensibles y clasificarlos con precisión en tiempo real o de forma programada. Además, la automatización ayuda a mantener un inventario actualizado de datos sensibles a medida que los sistemas evolucionan, los datos crecen y se incorporan nuevas fuentes.
Ejemplos de herramientas de descubrimiento de datos ampliamente utilizadas, como Microsoft Purview, ayudan a integrarse con herramientas de enmascaramiento de datos, reduciendo tanto el tiempo como el riesgo asociados con procesos manuales.
Establezca una taxonomía de datos
Una vez identificados los datos, deben clasificarse según el nivel de sensibilidad, el requisito regulatorio y el caso de uso del negocio. Esto se conoce como construir una taxonomía de datos. Una taxonomía bien definida ayuda a determinar:
- ¿Qué datos requieren enmascaramiento o cifrado?
- ¿Qué técnicas de enmascaramiento deben aplicarse?
- ¿Quién puede acceder a datos enmascarados o sin enmascarar?
- ¿Qué normativas aplican a cada categoría de datos?
Una taxonomía podría incluir categorías como:
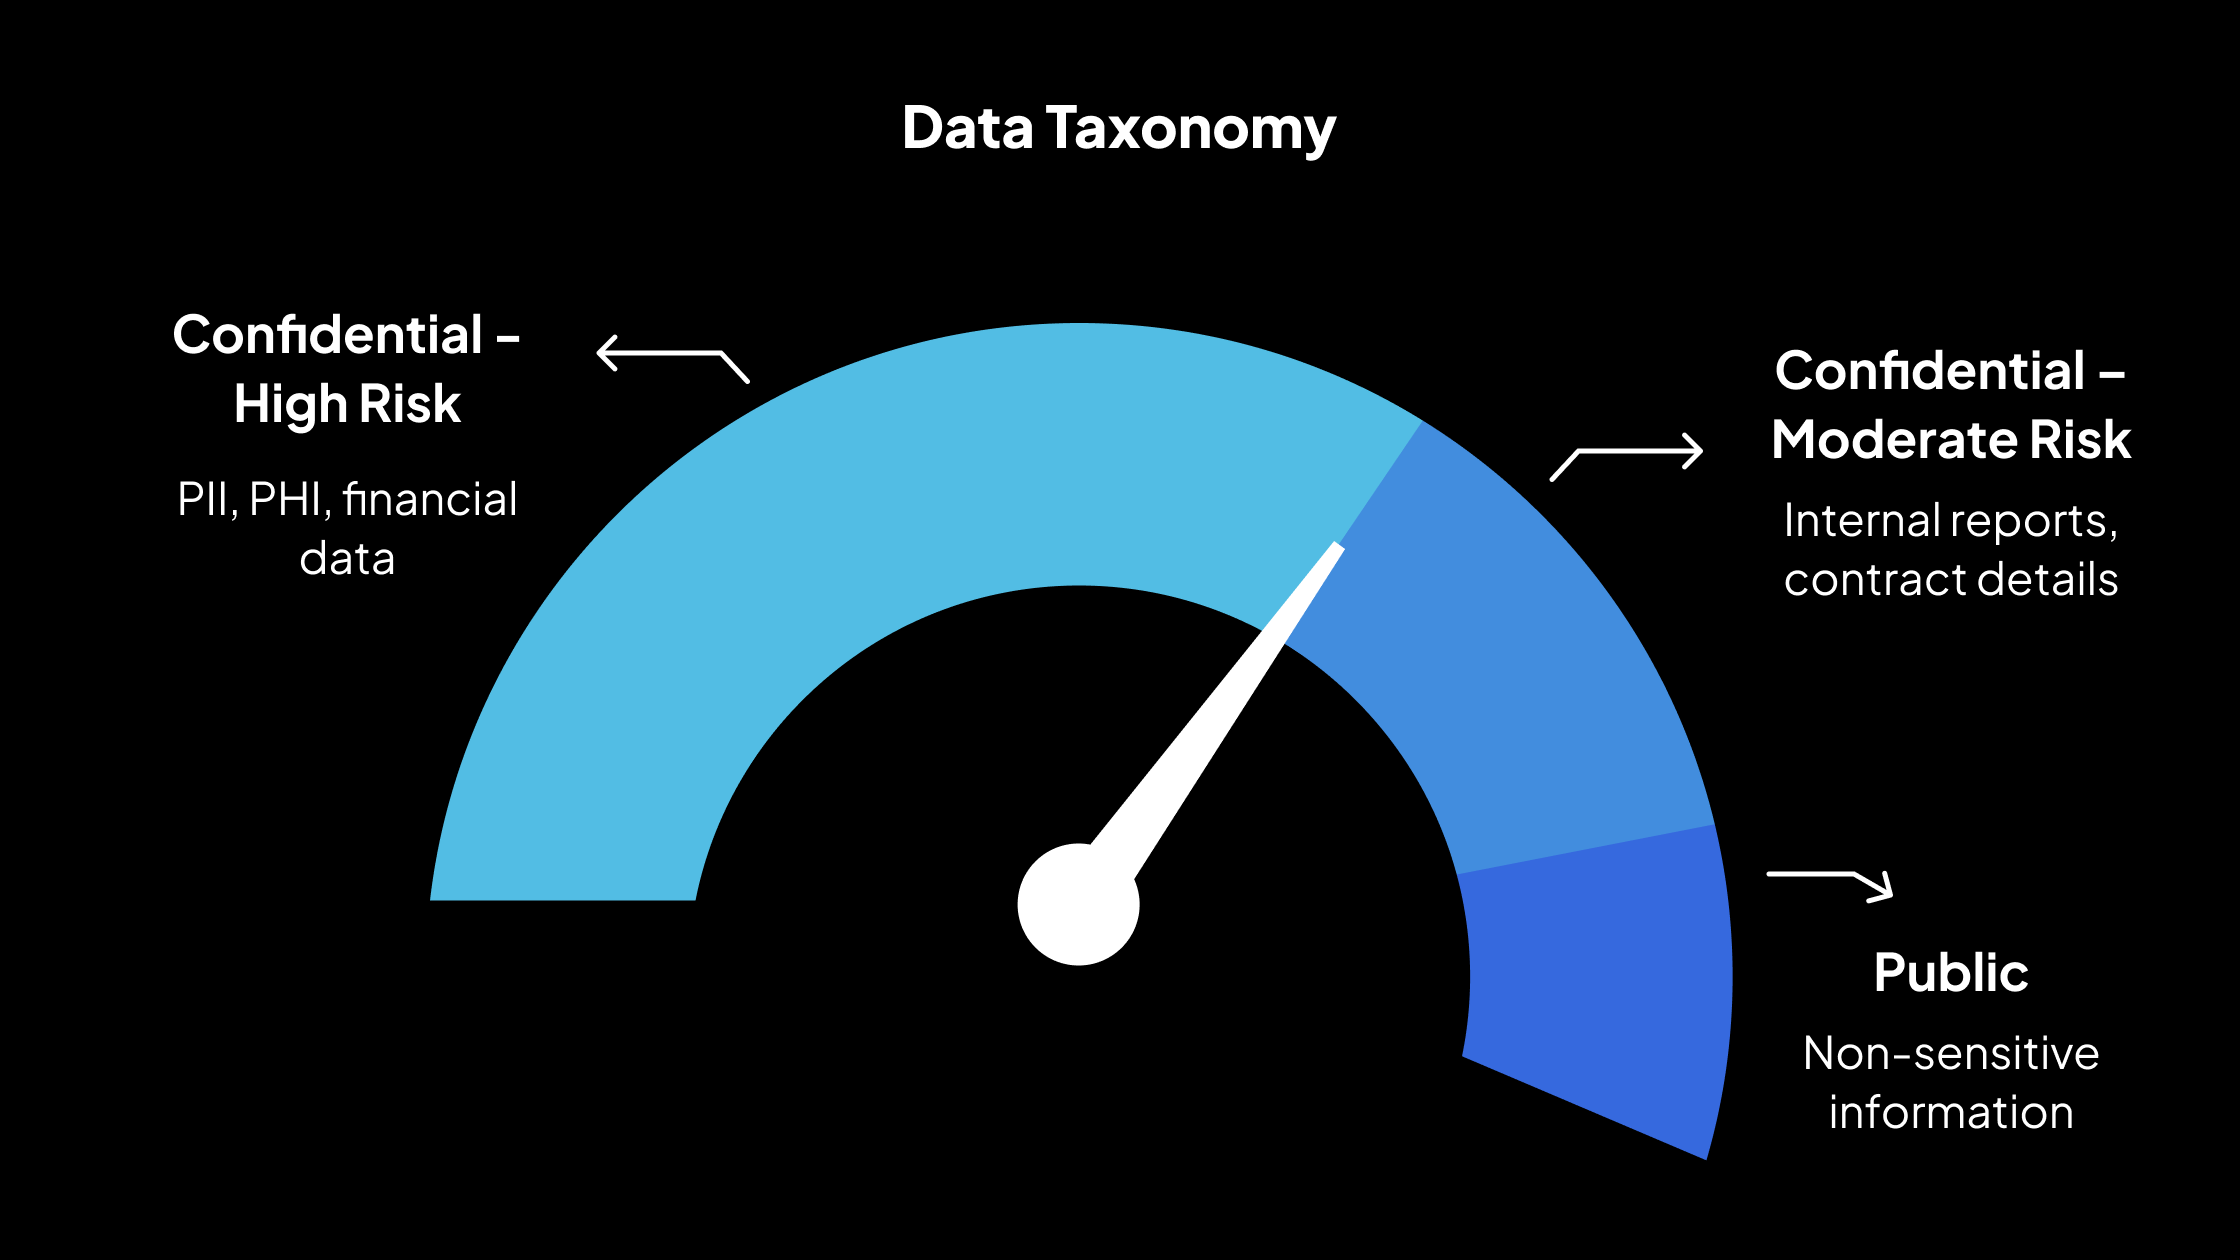
- Confidencial – Alto riesgo: PII, PHI, datos financieros (siempre deben enmascararse en entornos no productivos)
- Confidencial – Riesgo moderado: Informes internos, detalles de contratos (el enmascaramiento depende del caso de uso)
- Público: Información no sensible (no requiere enmascaramiento)
Establecer y mantener esta taxonomía garantiza la consistencia en toda la organización y simplifica los reportes regulatorios y las auditorías. También permite una aplicación precisa y basada en riesgos del enmascaramiento de datos, reduciendo tanto la sobrecarga operativa como la ofuscación innecesaria de datos.
2. Elija técnicas de enmascaramiento de datos adecuadas
Seleccionar la técnica correcta de enmascaramiento de datos es crucial para lograr un equilibrio entre seguridad, cumplimiento y usabilidad. La elección depende del tipo de datos, el propósito del enmascaramiento y el entorno en el que se utilizarán los datos enmascarados.
Enmascaramiento de datos estático vs. dinámico
Enmascaramiento de datos estático (SDM)
El enmascaramiento de datos estático implica crear una copia enmascarada de una base de datos o conjunto de datos. El proceso de enmascaramiento se realiza una sola vez sobre los datos originales, y el conjunto de datos resultante se utiliza en entornos no productivos (p. ej., desarrollo, pruebas, formación).
Los datos enmascarados son persistentes y se almacenan por separado de los datos originales. El SDM garantiza que los datos sensibles nunca se expongan en estos entornos porque los datos originales nunca salen de los sistemas de producción.
Enmascaramiento de datos dinámicos (DDM)
El enmascaramiento de datos dinámico aplica el enmascaramiento al vuelo, en tiempo de ejecución de la consulta. Los datos originales permanecen intactos en la base de datos, pero los usuarios ven valores enmascarados según sus derechos de acceso. Las reglas de enmascaramiento se aplican en tiempo real, garantizando que los datos sensibles estén protegidos sin necesidad de conjuntos de datos separados.
Se utiliza en sistemas de producción donde ciertos usuarios (p. ej., equipos de soporte, contratistas) requieren vistas restringidas, así como en portales de atención al cliente donde se necesita visibilidad parcial de los datos. El DDM ofrece flexibilidad y reduce la sobrecarga de almacenamiento, pero requiere una configuración cuidadosa del control de acceso.
Métodos de enmascaramiento
Sustitución
La sustitución reemplaza valores sensibles por valores realistas, pero falsos, provenientes de un conjunto de datos predefinido. Por ejemplo, reemplazar nombres reales por nombres de una lista de muestra. Se utiliza para enmascarar PII (nombres, direcciones) y es adecuada para entornos de prueba y demostración donde se requieren datos realistas.
Mezcla
La mezcla aleatoriza los datos dentro de una columna. Por ejemplo, los correos electrónicos de clientes pueden mezclarse para que ningún registro conserve su correo original. Se utiliza para pruebas internas donde el formato importa, pero las relaciones exactas de valores no, y en escenarios donde la consistencia de datos entre filas no es crítica.
Cifrado
El cifrado transforma los datos en un formato ilegible mediante algoritmos criptográficos. Solo los usuarios autorizados con claves de descifrado pueden acceder a los datos originales.
Se utiliza para proteger datos sensibles en tránsito o en reposo, así como en entornos de alta seguridad donde los datos deben cifrarse para usuarios específicos.
Tokenización
La tokenización reemplaza los datos sensibles por un valor único generado aleatoriamente (token). La relación entre los datos originales y el token se mantiene en una bóveda de tokens segura.
Se utiliza para el procesamiento de pagos (p. ej., reemplazar números de tarjetas de crédito por tokens)
Y en sistemas que requieren trazabilidad entre los datos originales y los enmascarados
Preserve la integridad de los datos
Es esencial que el enmascaramiento de datos no rompa aplicaciones o procesos que dependen de los datos. La integridad referencial garantiza que las relaciones entre elementos de datos (p. ej., restricciones de clave foránea en bases de datos) se mantengan intactas después del enmascaramiento.
Aquí hay algunas consideraciones esenciales
- Enmascaramiento consistente: El mismo valor original siempre debe mapearse al mismo valor enmascarado cuando sea necesario (p. ej., IDs de clientes entre tablas).
- Preservación de formato: Los datos enmascarados deben conservar el formato de los datos originales (p. ej., formatos de fecha, longitudes de cadena) para evitar errores en las aplicaciones que los usan.
- Compatibilidad con la lógica de negocio: El enmascaramiento no debe interferir con la lógica del sistema, los reportes o la analítica.
No preservar la integridad puede provocar fallas en pruebas, resultados incorrectos o sistemas rotos en entornos no productivos.
3. Implemente controles de acceso basados en roles (RBAC)
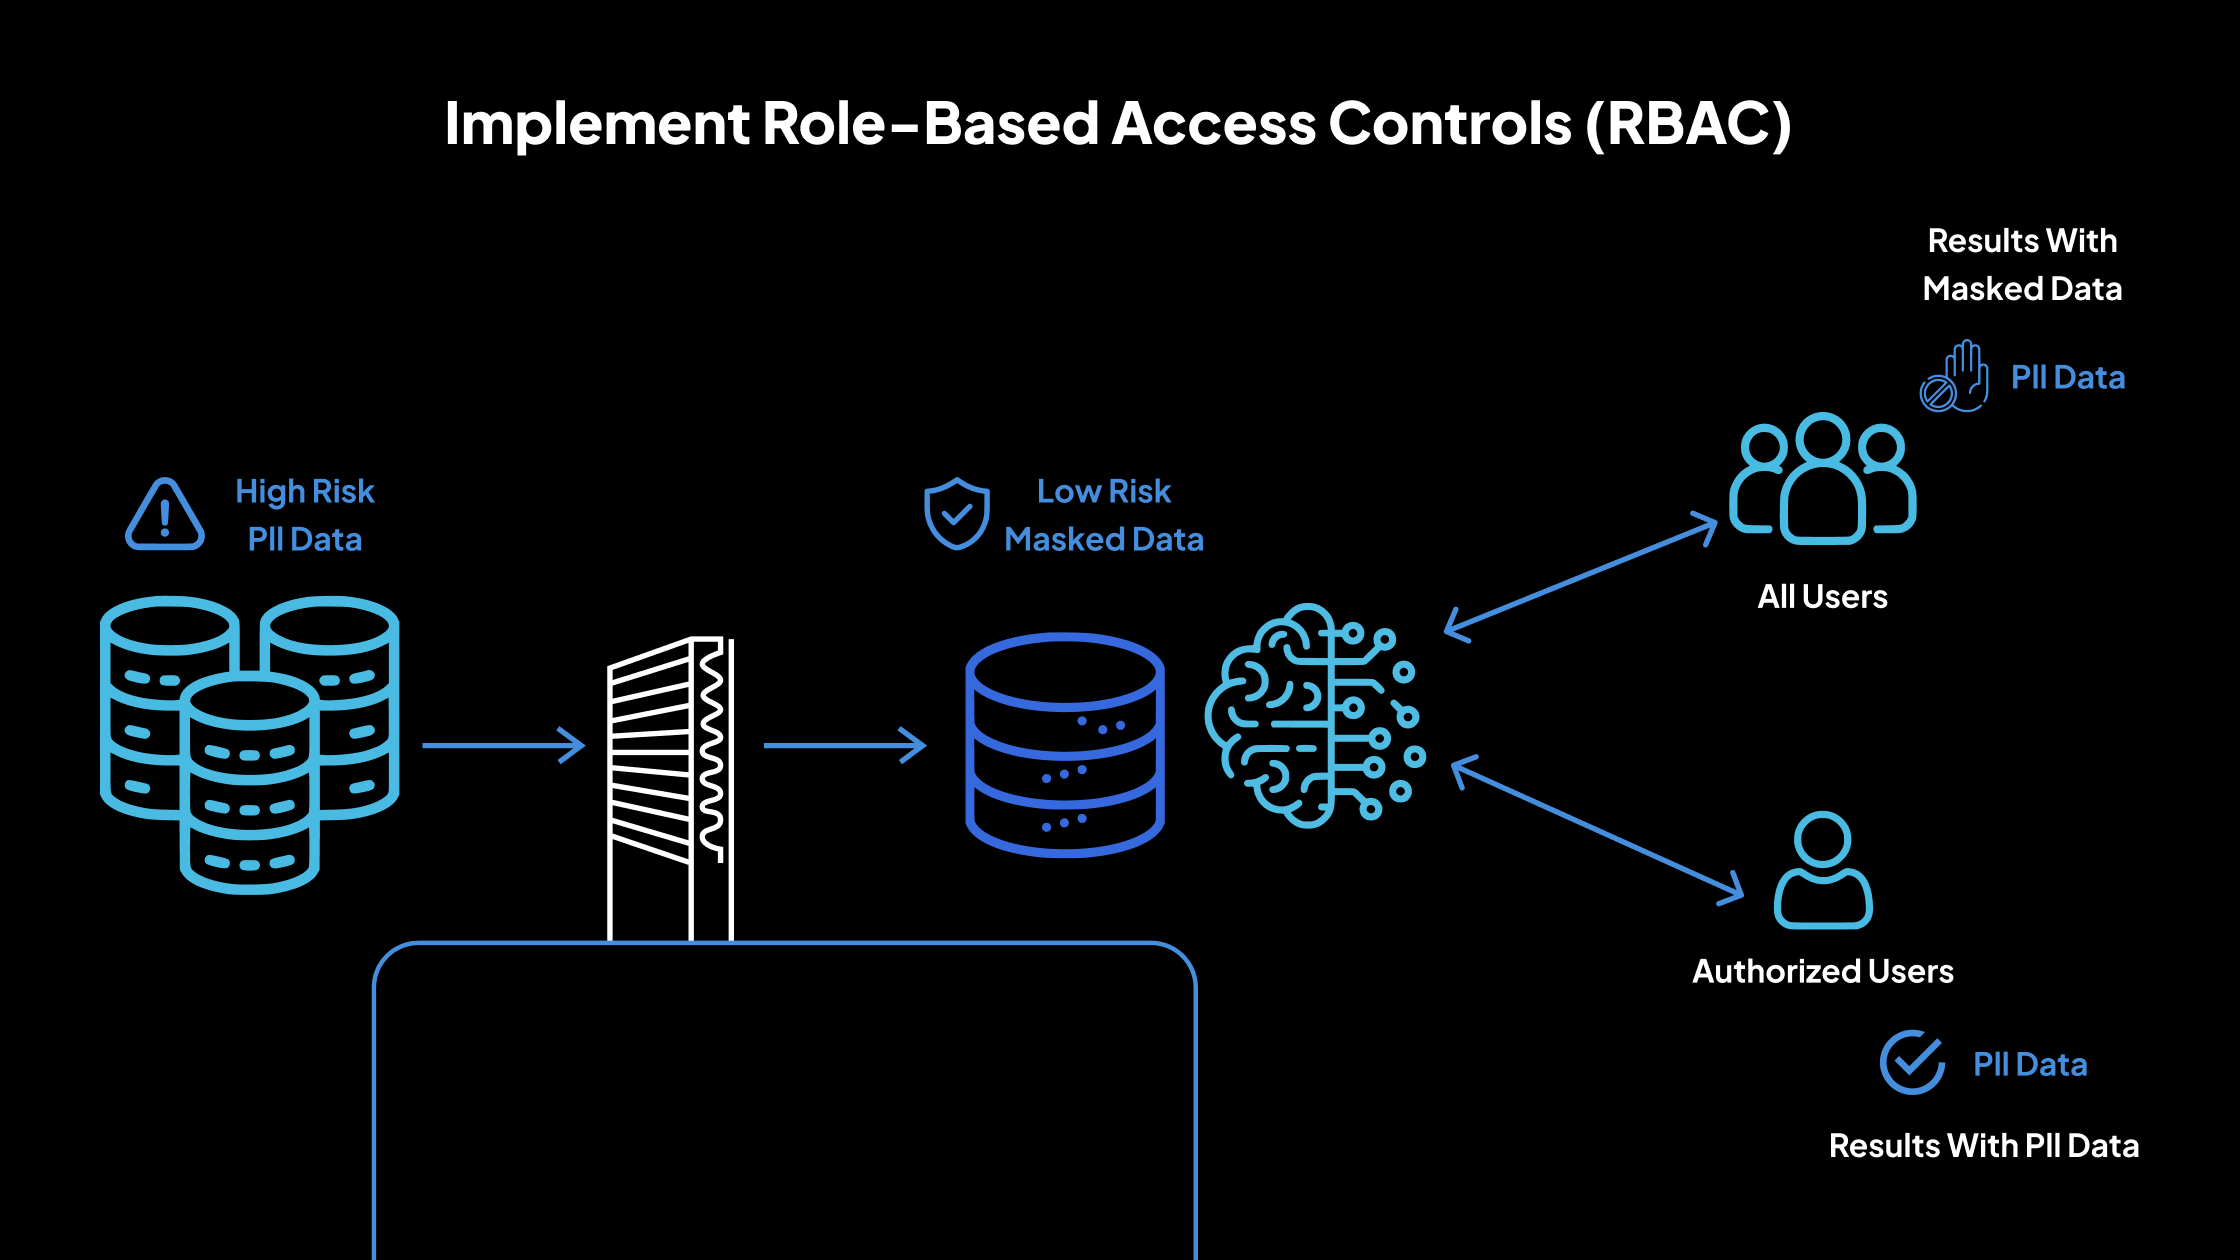
El control de acceso basado en roles (RBAC) es un mecanismo de seguridad que ayuda a garantizar que los datos sensibles solo sean accesibles para personas autorizadas. Al asignar permisos según los roles de trabajo, las organizaciones pueden reducir el riesgo de exposición no autorizada de datos y mantener el cumplimiento de las normativas de protección de datos.
Defina roles de usuario
El primer paso en RBAC es definir claramente los roles de usuario dentro de la organización. Cada rol debe reflejar funciones y responsabilidades específicas. Por ejemplo:
| Administrador de base de datos | Desarrollador | Analista de datos |
| Requiere acceso para gestionar y mantener bases de datos, incluidos datos enmascarados y sin enmascarar. | Necesita acceso a datos enmascarados para pruebas, pero no acceso a producción ni a datos sin enmascarar. | Puede trabajar con datos agregados o anonimizados, sin acceso a datos personales identificables. |
Los roles deben mapearse a derechos de acceso según el principio de mínimo privilegio; a los usuarios se les otorgan solo los permisos necesarios para realizar sus funciones. Esto reduce el riesgo de uso indebido accidental o intencional de datos sensibles.
Restrinja el acceso a datos sensibles
Una vez definidos los roles, es crucial aplicar restricciones de acceso. Los datos sensibles, como la información de identificación personal (PII) o la información de salud protegida (PHI), solo deben ser visibles sin enmascarar para personas con una necesidad legítima del negocio.
Por ejemplo, los desarrolladores que trabajan en entornos no productivos solo deben interactuar con datos enmascarados o anonimizados. Los equipos de atención al cliente pueden ver datos parciales (p. ej., los últimos cuatro dígitos de una tarjeta de crédito) en lugar de conjuntos de datos completos.
Estas restricciones ayudan a proteger los datos de amenazas internas y exposición accidental, a la vez que respaldan las operaciones del negocio. Las bases de datos y aplicaciones modernas suelen ofrecer soporte integrado para permisos basados en roles, lo que facilita aplicar estos controles.
Monitoree y audite el acceso
El RBAC debe respaldarse con monitoreo y auditoría continuos para garantizar que se cumplan las políticas de acceso e identificar cualquier anomalía. Esto implica registrar todas las actividades de acceso a datos, incluidas las consultas ejecutadas sobre datos sensibles, los cambios en las reglas de enmascaramiento y las modificaciones de permisos.
Revisar regularmente los registros de auditoría ayuda a identificar intentos de acceso no autorizados o patrones sospechosos, y generar reportes para fines de cumplimiento demuestra a los reguladores que el acceso a los datos está controlado y monitoreado.
Las herramientas de monitoreo automatizado pueden proporcionar alertas en tiempo real cuando se violan las políticas de acceso, lo que permite actuar rápidamente para contener riesgos potenciales.
4. Audite y actualice periódicamente las políticas de enmascaramiento
El enmascaramiento de datos no es una actividad única. A medida que evolucionan los entornos de negocio, los sistemas de datos y los requisitos regulatorios, las políticas de enmascaramiento deben revisarse y actualizarse para garantizar su efectividad continua. Un enfoque sistemático para auditar y actualizar estas políticas ayuda a las organizaciones a reducir el riesgo y mantener el cumplimiento.
Adáptese a los cambios
Las políticas de enmascaramiento deben ser lo suficientemente flexibles como para ajustarse cuando cambien elementos clave del entorno de negocio o técnico.
Ejemplos de estos cambios incluyen modificaciones en las estructuras de datos, como nuevos campos agregados a una base de datos o cambios de esquema en un data warehouse; actualizaciones en procesos de negocio que introducen nuevos flujos de datos o cambian cómo se manejan los datos sensibles; y nuevas o revisadas normativas de privacidad de datos (p. ej., actualizaciones del RGPD, la CCPA o la introducción de nuevas leyes regionales).
Si las reglas de enmascaramiento no contemplan estos cambios, los datos sensibles podrían quedar expuestos. Por lo tanto, las organizaciones deben contar con un proceso formal para actualizar las políticas de enmascaramiento cada vez que cambien los sistemas o los requisitos de cumplimiento. Este proceso debe implicar colaboración entre los equipos de gobierno de datos, cumplimiento y TI para asegurar que se cubran todos los ángulos.
Realice revisiones periódicas
Las organizaciones deben realizar auditorías regulares para verificar que sus políticas y controles de enmascaramiento funcionen según lo previsto. Estas revisiones deben comprobar que todos los datos sensibles estén enmascarados adecuadamente en todos los entornos, incluidas réplicas de producción, respaldos y sistemas de prueba.
Verificar la deriva de políticas, donde las reglas de enmascaramiento pueden ya no alinearse con las necesidades actuales del negocio o regulatorias, y probar la efectividad del enmascaramiento, asegurando que los datos enmascarados no puedan ser sometidos a ingeniería inversa ni reidentificados.
Un ciclo de auditoría puede ser trimestral o semestral, dependiendo de la sensibilidad de los datos y los requisitos regulatorios. Los resultados de la auditoría deben documentarse y compartirse con las partes interesadas, incluidos los equipos de cumplimiento y seguridad.
Incorpore bucles de retroalimentación
Los hallazgos de auditoría deben alimentar directamente el proceso de mejora de las prácticas de enmascaramiento. Este bucle de retroalimentación garantiza que las debilidades identificadas durante las auditorías se traduzcan en mejoras accionables en técnicas o políticas de enmascaramiento; que los nuevos riesgos se aborden con rapidez, evitando la exposición de datos antes de que los problemas escalen; y que las estrategias de enmascaramiento sigan alineadas con los objetivos del negocio y los estándares regulatorios.
Incorporar retroalimentación ayuda a crear un ciclo de mejora continua. Las políticas de enmascaramiento no deben permanecer estáticas; deben evolucionar en función de hallazgos internos y cambios externos para garantizar la seguridad de los datos y el cumplimiento.
5. Integre el enmascaramiento de datos en el ciclo de vida del desarrollo
Para construir sistemas seguros y conformes, el enmascaramiento de datos debe integrarse en cada etapa del ciclo de vida del desarrollo de software (SDLC). Esto garantiza que los datos sensibles estén protegidos no solo en producción, sino también en entornos no productivos donde los datos suelen estar en mayor riesgo debido a un acceso más amplio y menos controles.
Asegure los entornos no productivos
Los entornos de desarrollo, pruebas y formación a menudo requieren datos realistas para simular condiciones de producción. Sin embargo, usar datos reales de producción en estos entornos crea un riesgo de seguridad significativo. Los sistemas no productivos suelen tener controles de seguridad más bajos, un acceso más amplio por parte de terceros o contratistas y un mayor riesgo de fuga accidental de datos.
Aplique siempre el enmascaramiento de datos a los datos sensibles antes de copiarlos o moverlos a entornos no productivos. Las técnicas de enmascaramiento deben garantizar que los datos conserven su estructura y su integridad referencial para que las actividades de prueba y desarrollo no se vean interrumpidas.
Esto protege la información de identificación personal (PII), la información de salud protegida (PHI) y los datos financieros de una exposición innecesaria, a la vez que permite a los equipos trabajar con conjuntos de datos realistas.
Automatice los procesos de enmascaramiento
El enmascaramiento manual de datos consume tiempo, es propenso a errores y es difícil de escalar en entornos de desarrollo modernos, especialmente aquellos que emplean prácticas ágiles o DevOps. Para abordar esto, las organizaciones deben integrar herramientas automatizadas de enmascaramiento de datos en sus pipelines de CI/CD.
La automatización garantiza que el enmascaramiento se aplique de forma consistente cada vez que se actualicen los datos en entornos no productivos, reduce el error humano y refuerza el cumplimiento de las políticas de enmascaramiento.
Las soluciones de enmascaramiento automatizado pueden configurarse para ejecutarse como parte de procesos de compilación, despliegue o actualización de datos. Esto garantiza que ningún dato sin enmascarar entre en sistemas de prueba o desarrollo, respaldando principios de seguridad por diseño.
Capacite a los equipos de desarrollo
La tecnología por sí sola no es suficiente. Los equipos de desarrollo y pruebas deben comprender la importancia del enmascaramiento de datos y su papel en prácticas de software seguro. Sin la concientización adecuada, los equipos podrían omitir controles de enmascaramiento o exponer datos sensibles sin querer.
Explique los riesgos asociados con usar datos reales de producción en entornos no productivos. Guíe prácticas de codificación segura que se alineen con los requisitos de enmascaramiento de datos. Enseñe cómo trabajar con datos enmascarados durante depuración, pruebas y análisis sin comprometer la seguridad.
Talleres regulares, documentación e integración de temas de seguridad de datos en programas de onboarding de desarrollo ayudan a construir una cultura de conciencia de seguridad.
6. Garantice el cumplimiento de las normativas de protección de datos
El enmascaramiento de datos desempeña un papel crucial para ayudar a las organizaciones a cumplir con las leyes de protección de datos. Para lograr y mantener el cumplimiento, es esencial alinear las prácticas de enmascaramiento con los estándares legales, documentar estos esfuerzos y monitorear continuamente los cambios regulatorios.
Comprenda los requisitos regulatorios
Diferentes leyes de protección de datos especifican cómo deben manejar y proteger las organizaciones la información sensible. Es esencial comprender las obligaciones relacionadas con el enmascaramiento de datos bajo estas normativas:
- RGPD (Reglamento General de Protección de Datos) — Exige que los responsables y encargados del tratamiento implementen medidas técnicas adecuadas, como la seudonimización y el enmascaramiento de datos, para proteger los datos personales (Artículo 32). El enmascaramiento respalda los principios del RGPD al minimizar la exposición de información identificable en entornos no productivos o durante el intercambio de datos.
- HIPAA (Health Insurance Portability and Accountability Act) — Exige la protección de la información de salud protegida (PHI). El enmascaramiento ayuda a cumplir con los requisitos de la Regla de Privacidad y Seguridad de la HIPAA al desidentificar la PHI cuando se usa fuera de sistemas clínicos.
- CCPA (California Consumer Privacy Act) — Enfatiza los derechos del consumidor sobre la información personal. El enmascaramiento de datos reduce el riesgo de divulgación no autorizada, respaldando el cumplimiento de las disposiciones de seguridad de datos de la CCPA.
Comprender estos requisitos legales ayuda a determinar dónde y cómo debe aplicarse el enmascaramiento, garantizando que las estrategias de enmascaramiento estén diseñadas para cumplir necesidades específicas de cumplimiento.
Documente los esfuerzos de cumplimiento
Para demostrar el cumplimiento durante auditorías o revisiones regulatorias, es esencial mantener registros claros y precisos de las actividades de enmascaramiento de datos. Esto incluye documentos de políticas de enmascaramiento que describen qué elementos de datos se enmascaran, las técnicas utilizadas y las razones del enmascaramiento.
Registros de procesos que muestran cómo se aplica el enmascaramiento durante migraciones de datos, actualizaciones de entornos o actividades de intercambio de datos. Registros de acceso que detallan quién aplicó o modificó reglas de enmascaramiento, junto con las fechas y horas de estos cambios. La documentación adecuada no solo respalda la preparación para auditorías, sino que también ayuda a los equipos internos a revisar y mejorar las prácticas de enmascaramiento con el tiempo.
Manténgase al tanto de actualizaciones legales
Las normativas de privacidad de datos siguen evolucionando a medida que los gobiernos introducen nuevas leyes y actualizan las existentes. Por ejemplo, la expansión de las leyes de privacidad a nivel estatal en EE. UU. (como la Colorado Privacy Act) ha agregado nuevas obligaciones de cumplimiento.
Las organizaciones deben mantenerse actualizadas sobre estos cambios para garantizar que las prácticas de enmascaramiento sigan siendo conformes. Esto puede lograrse mediante revisiones legales regulares en colaboración con equipos de cumplimiento o legales, monitoreando actualizaciones de organismos reguladores oficiales y grupos de defensa de la privacidad, y ajustando las políticas y herramientas de enmascaramiento según sea necesario para alinearse con nuevos requisitos.
Mantenerse proactivo reduce el riesgo de incumplimiento y garantiza que las medidas de protección de datos sigan siendo efectivas a medida que cambian las leyes.
Proteja la información sensible con la herramienta de enmascaramiento de datos inteligente de Avahi
Como parte de su compromiso con operaciones de datos seguras y conformes, la plataforma de IA de Avahi proporciona herramientas que permiten a las organizaciones gestionar información sensible de forma precisa y exacta. Una de sus características destacadas es el Enmascarador de Datos, diseñado para proteger datos financieros y de identificación personal mientras apoya la eficiencia operativa.
Descripción general del enmascarador de datos de Avahi
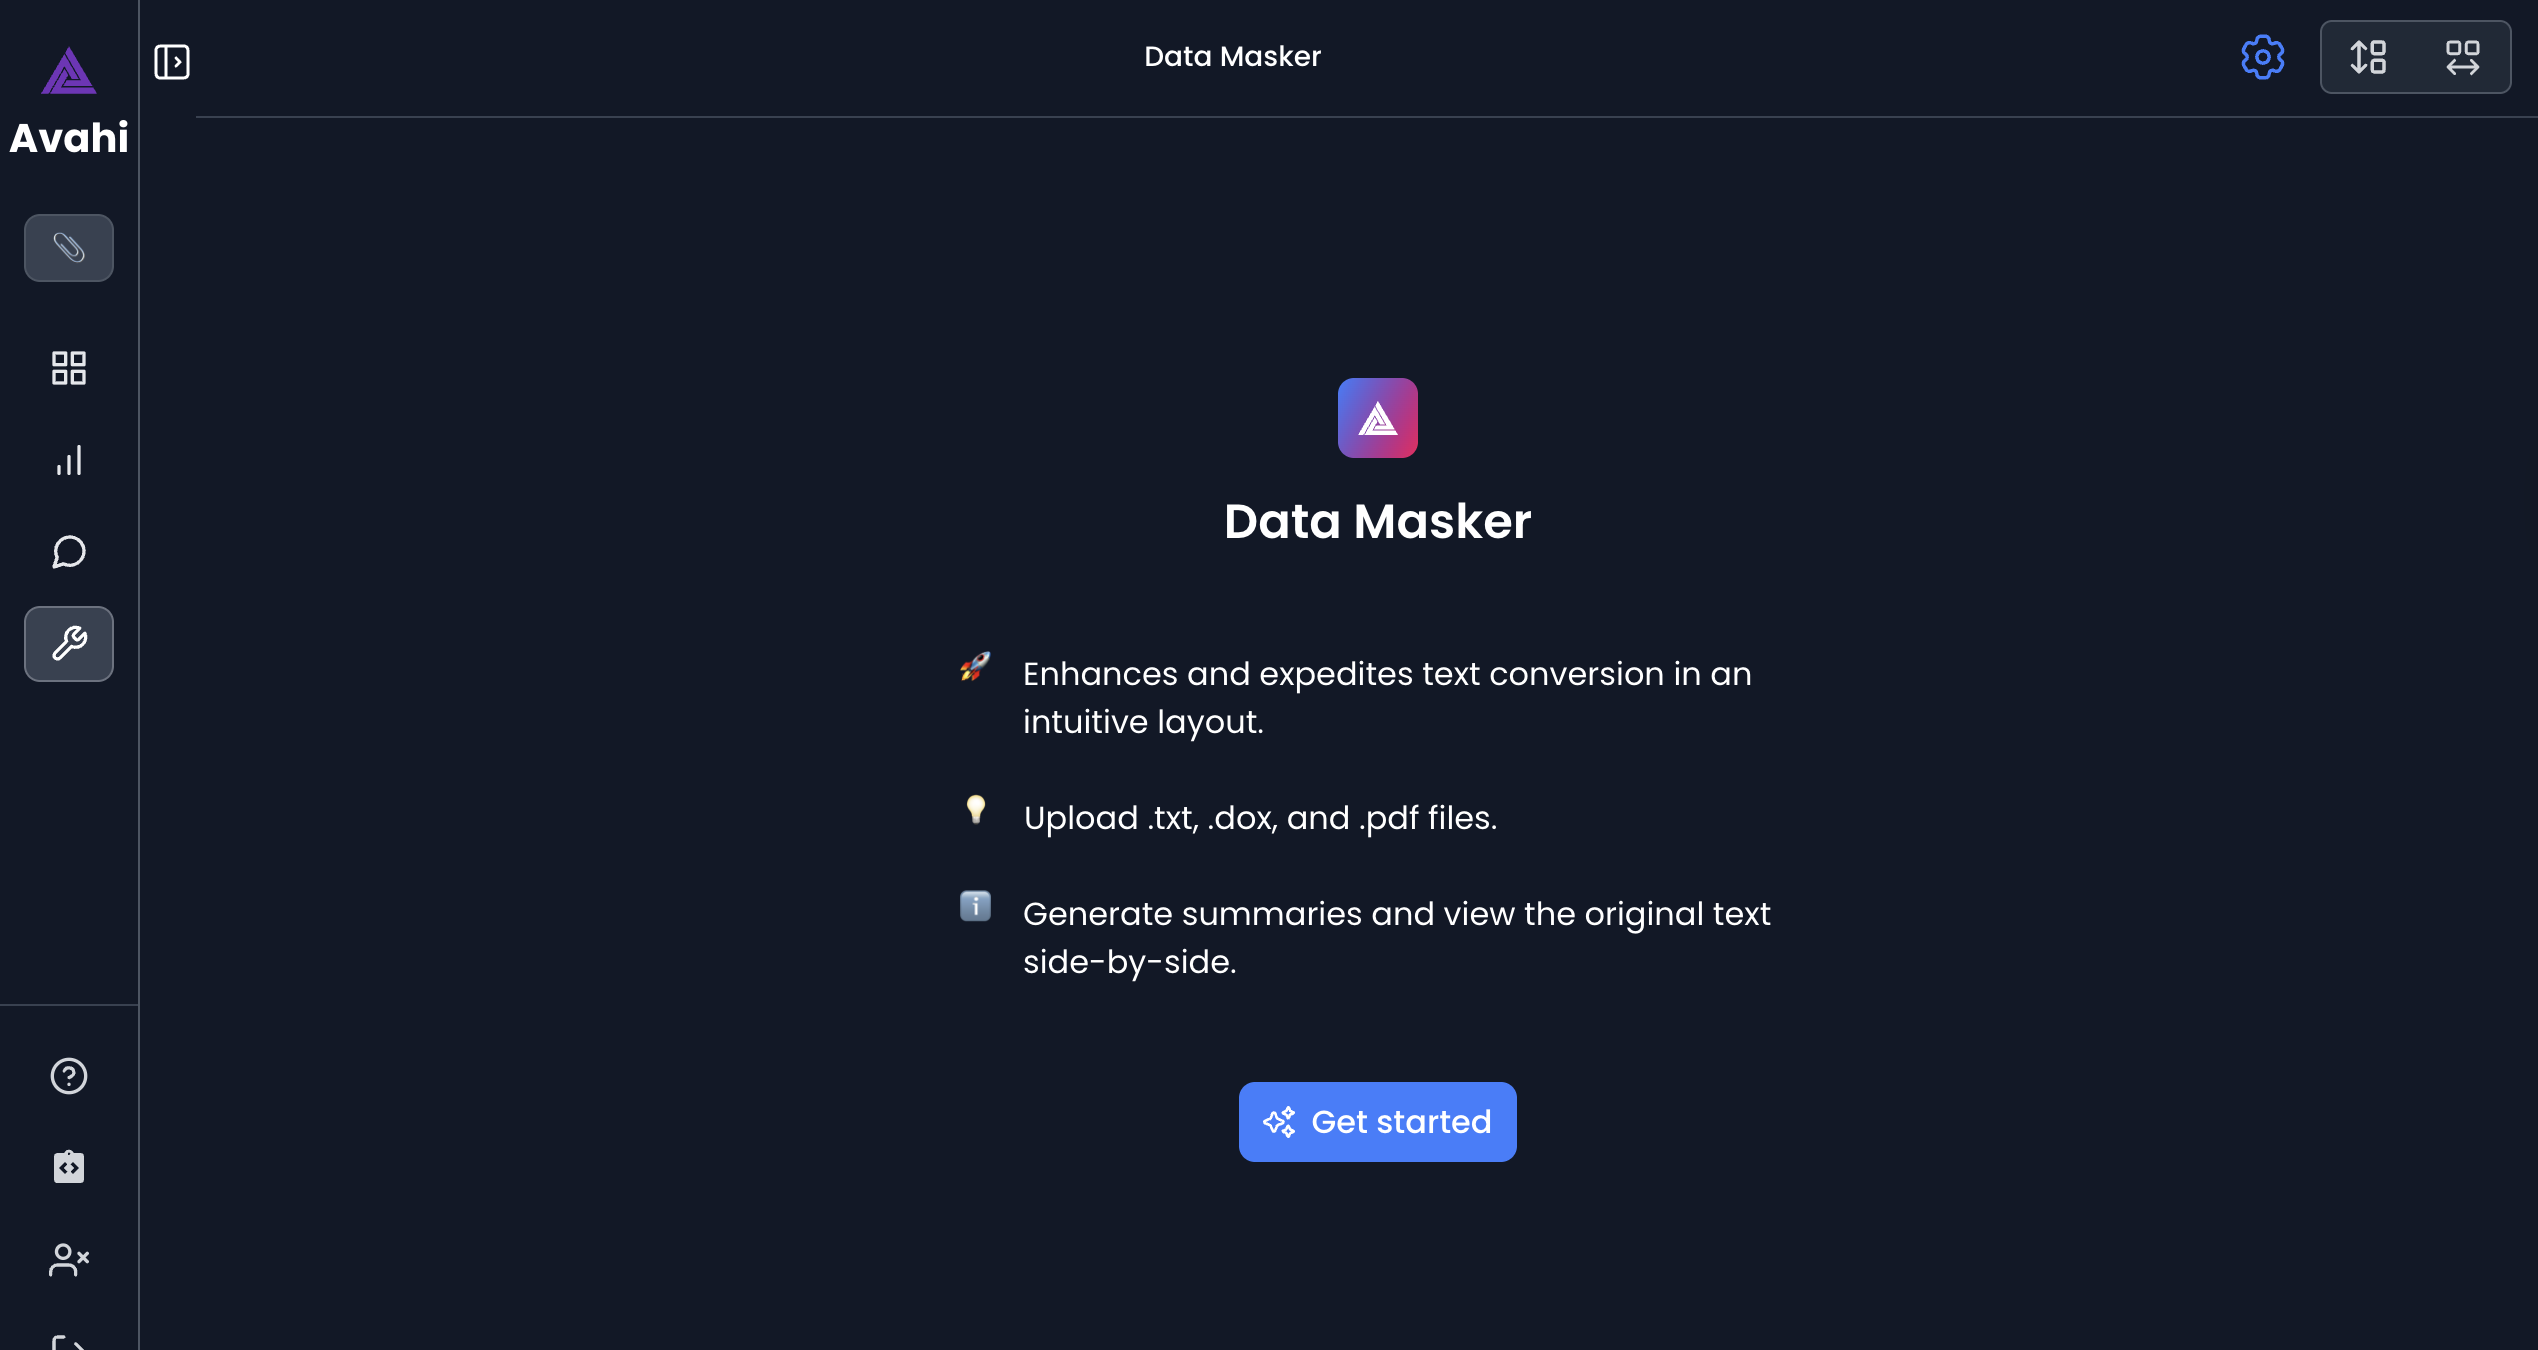
El Data Masker de Avahi es una herramienta versátil de protección de datos diseñada para ayudar a las organizaciones a manejar de forma segura información sensible en diversas industrias, incluidas salud, finanzas, retail y seguros.
La herramienta permite a los equipos enmascarar datos confidenciales como números de cuenta, registros de pacientes, identificadores personales y detalles de transacciones sin interrumpir los flujos de trabajo operativos.
El Data Masker de Avahi garantiza que solo los usuarios autorizados puedan ver o interactuar con datos sensibles al aplicar técnicas avanzadas de enmascaramiento y hacer cumplir el control de acceso basado en roles. Esto es especialmente importante cuando múltiples departamentos o proveedores externos acceden a los datos.
Ya sea protegiendo información de salud de pacientes en cumplimiento con HIPAA, anonimizando registros financieros para PCI DSS o asegurando datos de clientes para el RGPD, la herramienta ayuda a las organizaciones a minimizar el riesgo de acceso no autorizado mientras preserva la usabilidad de los datos para desarrollo, analítica y monitoreo de fraude.
Simplifique la protección de datos con la solución de enmascaramiento de datos impulsada por IA de Avahi
En Avahi, reconocemos la importancia crucial de salvaguardar la información sensible mientras se mantienen flujos de trabajo operativos sin interrupciones.
Con Data Masker de Avahi, tu organización puede proteger fácilmente datos confidenciales, desde salud hasta finanzas, manteniendo el cumplimiento normativo con estándares como HIPAA, PCI DSS y GDPR.
Nuestra solución de enmascaramiento de datos combina técnicas avanzadas impulsadas por IA con control de acceso basado en roles para mantener tus datos seguros y utilizables para desarrollo, analítica y detección de fraude.
Ya sea que necesites anonimizar registros de pacientes, transacciones financieras o identificadores personales, Data Masker de Avahi ofrece un enfoque intuitivo y seguro para la protección de datos.
¿Listo para proteger tus datos y garantizar el cumplimiento? ¡Comienza con Data Masker de Avahi!
Programar una llamada de demostración
Preguntas frecuentes
1) ¿Cuáles son las mejores prácticas de enmascaramiento de datos que las organizaciones deben seguir?
Las mejores prácticas de enmascaramiento de datos incluyen realizar un descubrimiento integral de datos, seleccionar las técnicas de enmascaramiento adecuadas, implementar controles de acceso basados en roles, auditar periódicamente las políticas de enmascaramiento, integrar el enmascaramiento en el ciclo de vida del desarrollo y garantizar el cumplimiento de las normativas de protección de datos. Estas prácticas ayudan a proteger información sensible, a la vez que respaldan necesidades operativas y de cumplimiento.
2) ¿Por qué el enmascaramiento de datos es necesario para el cumplimiento y la seguridad?
El enmascaramiento de datos es crucial porque evita el acceso no autorizado a datos sensibles, reduce el riesgo de brechas de datos y garantiza el cumplimiento de normativas como el RGPD, la HIPAA y la CCPA. Permite a las organizaciones trabajar con datos realistas en entornos no productivos sin exponer información confidencial real.
3) ¿Cuál es la diferencia entre el enmascaramiento de datos estático y dinámico?
El enmascaramiento de datos estático crea una copia enmascarada de un conjunto de datos que se usa en entornos no productivos, como desarrollo o pruebas. El enmascaramiento de datos dinámico enmascara los datos en tiempo de ejecución de la consulta, mostrando valores enmascarados a usuarios no autorizados mientras conserva los datos originales en sistemas de producción.
4) ¿Cómo respalda el enmascaramiento de datos la seguridad en la nube?
El enmascaramiento de datos respalda la seguridad en la nube al garantizar que los datos sensibles almacenados o procesados en la nube estén ofuscados. Incluso si los datos en la nube se manejan mal o se exponen, los datos enmascarados son inútiles para los atacantes. Esto es crucial, ya que la mayoría de las organizaciones ahora dependen de entornos multinube.
5) ¿El enmascaramiento de datos afecta la utilidad de los datos para pruebas y analítica?
No. Cuando se hace correctamente, el enmascaramiento de datos conserva el formato y la estructura de los datos originales. Esto permite a los equipos realizar pruebas, formación y análisis realistas sin exponer información sensible.