

TL;DR
|
Un estudio reciente de Gartner predice que para 2026, 75% de la población mundial tendrá sus datos protegidos por las regulaciones de privacidad. Al mismo tiempo, un informe reciente de Delphix revela que 54% de las organizaciones han sufrido violaciones de datos en entornos que no son de producción, y el 86% permite excepciones de cumplimiento de datos en contextos de prueba y control de calidad.
Esta combinación crea un escenario de alto riesgo: los datos sensibles de producción se están copiando, compartiendo y usando en lugares para los que nunca fueron destinados.
El enmascaramiento de datos aborda este riesgo directamente al reemplazar valores sensibles, como nombres, correos electrónicos o detalles financieros, por datos realistas pero no identificables. Permite que desarrolladores, analistas y científicos de datos trabajen de forma productiva, sin manipular nunca datos en vivo que podrían desencadenar violaciones de cumplimiento o incidentes de seguridad.
Aquí es donde DataMasque entra en juego. Diseñado para entornos en la nube como AWS, DataMasque automatiza el descubrimiento y el enmascaramiento de datos sensibles en fuentes estructuradas y semiestructuradas, garantizando el cumplimiento sin interrumpir los flujos de trabajo operativos.
En este blog, exploraremos por qué el enmascaramiento de datos en AWS es esencial para operaciones seguras y conformes en AWS y cómo DataMasque encaja en los procesos de datos modernos y en entornos de desarrollo/pruebas.
Ya sea que estés preparando datos para equipos de control de calidad, modelos de machine learning o migrando cargas de trabajo a la nube, esta guía te mostrará cómo proteger tus datos sin frenar la innovación.
Entendiendo DataMasque: una solución diseñada específicamente para el enmascaramiento de datos en AWS
DataMasque es una solución especializada de enmascaramiento de datos diseñada para proteger información sensible, incluida la Información de Identificación Personal (PII), la Información de Salud Protegida (PHI) y los datos de pago. Se utiliza principalmente para generar conjuntos de datos realistas y desidentificados para desarrollo, pruebas, analítica y entrenamiento de IA, sin exponer datos de producción en vivo.
El objetivo principal de DataMasque es proteger los datos sensibles transformándolos en datos enmascarados y sintéticos que no pueden revertirse. Esto garantiza que las empresas puedan usar de forma segura réplicas de datos en entornos que no son de producción, manteniendo al mismo tiempo la utilidad de los datos para tareas funcionales. Aquí tienes una lista de algunas de las capacidades clave de DataMasque:
1. Descubrimiento de datos sensibles
DataMasque incluye reglas de detección integradas para identificar datos sensibles en una amplia variedad de sistemas de origen. También puede configurarse con reglas de descubrimiento personalizadas para alinearse con las necesidades de la organización o los requisitos de cumplimiento.
Incluye patrones predefinidos para nombres, correos electrónicos, números de tarjeta de crédito, fechas y otros identificadores estándar, y el descubrimiento funciona en varias bases de datos y tipos de archivo, reduciendo el esfuerzo manual.
2. Enmascaramiento de datos flexible
Una vez que se identifican los datos sensibles, DataMasque aplica técnicas de enmascaramiento irreversibles para garantizar la privacidad. Los métodos incluyen hashing, aleatorización, enmascaramiento que preserva el formato y reglas de sustitución personalizadas. Los datos enmascarados conservan una estructura realista y la integridad referencial, lo que significa que las relaciones entre columnas de datos (p. ej., ID de usuario y correo electrónico) se mantienen lógicamente consistentes.
3. Soporte para datos estructurados y semiestructurados
DataMasque admite formatos tanto estructurados (p. ej., bases de datos relacionales) como semiestructurados (p. ej., JSON, XML, CSV). Compatible con plataformas como PostgreSQL, MySQL, Oracle, SQL Server, y Amazon RDS. El enmascaramiento basado en archivos permite procesar archivos planos, logs o conjuntos de datos exportados desde aplicaciones empresariales.
4. Implementación en AWS
DataMasque está disponible en AWS Marketplace como una Amazon Machine Image (AMI) preconfigurada que se ejecuta en Amazon EC2. Esto facilita su implementación dentro de entornos de AWS con una configuración mínima.
Se integra con servicios de AWS como Secrets Manager, Step Functions, y CloudFormation para automatización. Adecuado para tareas de enmascaramiento bajo demanda o programadas en entornos tanto cloud-native como híbridos.
Por qué el enmascaramiento de datos en AWS es esencial para la seguridad y el cumplimiento
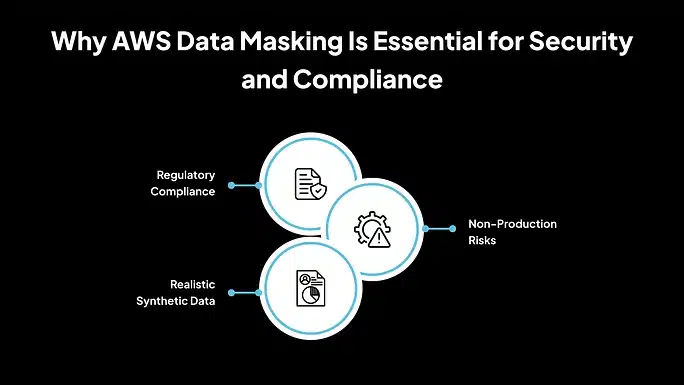
El enmascaramiento de datos es un componente crucial de las estrategias modernas de seguridad y cumplimiento de datos, particularmente en entornos en la nube como Amazon Web Services (AWS). A medida que las empresas migran su infraestructura y cargas de trabajo a AWS, necesitan asegurarse de que los datos sensibles estén protegidos en cada etapa de almacenamiento, procesamiento y pruebas. Aquí te explicamos por qué el enmascaramiento de datos es esencial en AWS:
1. Cumplimiento normativo
Las organizaciones que manejan datos sensibles deben cumplir con regulaciones regionales y específicas de la industria. Estas regulaciones exigen que los datos personales y confidenciales no se expongan de formas que puedan conducir a accesos no autorizados o uso indebido.
GDPR (Reglamento General de Protección de Datos) exige la protección de los datos personales de los ciudadanos de la UE. HIPAA (Health Insurance Portability and Accountability Act) establece lineamientos estrictos para proteger la Información de Salud Protegida (PHI) en el sector salud.
CCPA (California Consumer Privacy Act) otorga derechos y protecciones de privacidad a los residentes de California. PCI-DSS (Payment Card Industry Data Security Standard) garantiza el manejo seguro de tarjetas de crédito y datos de pago.
Usar soluciones de enmascaramiento de datos como DataMasque ayuda a las organizaciones en AWS a cumplir con estos requisitos regulatorios al convertir los datos sensibles en formatos desidentificados que conservan su utilidad, pero eliminan los riesgos de exposición.
2. Riesgos en entornos que no son de producción
Muchos equipos de desarrollo, pruebas y analítica requieren acceso a datos que reflejen las condiciones de producción. Sin embargo, usar datos reales de producción en entornos que no son de producción introduce riesgos graves, como la exposición de datos personales o financieros a usuarios internos, proveedores o contratistas externos.
Mayor superficie de ataque, ya que los entornos de desarrollo y prueba suelen ser menos seguros que los sistemas de producción, y filtraciones accidentales de datos a través de respaldos, logs o controles de acceso mal configurados.
Enmascarar los datos de producción antes de usarlos en entornos de prueba, desarrollo o entrenamiento reduce significativamente el riesgo de filtraciones y divulgaciones accidentales, al tiempo que sigue proporcionando datos utilizables y representativos.
3. Datos sintéticos realistas
Una de las principales ventajas del enmascaramiento de datos con herramientas como DataMasque es la generación de datos sintéticamente precisos. Estos datos enmascarados reflejan la estructura y la lógica del original, sin contener valores sensibles reales.
Los desarrolladores e ingenieros de control de calidad pueden trabajar con conjuntos de datos que se parecen a los de producción, lo que les permite validar con precisión el rendimiento, la usabilidad y el manejo de errores. Los modelos de machine learning entrenados con datos realistas pero anonimizados mantienen la calidad del rendimiento, al tiempo que reducen las preocupaciones de cumplimiento.
Las herramientas de inteligencia empresarial pueden procesar conjuntos de datos enmascarados para obtener insights, tendencias y pronósticos, sin violar las reglas de privacidad de datos. Esto permite que los equipos mantengan la productividad y la precisión en flujos de trabajo cloud-native en AWS sin comprometer la privacidad o la seguridad de los datos.
Cómo opera DataMasque dentro del ecosistema de AWS
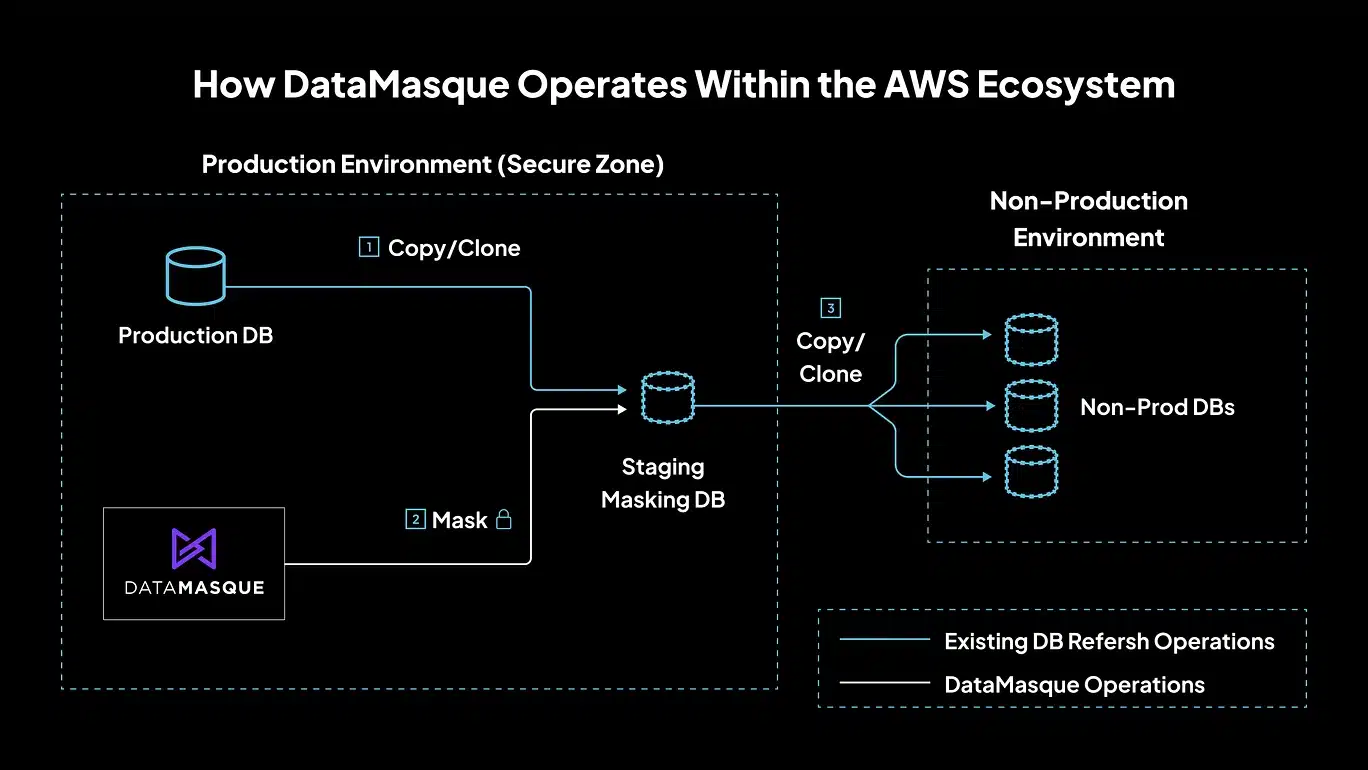
DataMasque se integra perfectamente con la infraestructura de AWS para proporcionar enmascaramiento de datos automatizado y seguro. Está diseñado para ser fácil de implementar, escalable entre entornos y adaptable a diferentes requisitos de cumplimiento. A continuación, se presenta un desglose de cómo funciona en varias áreas:
1. Opciones de implementación
AMI de AWS Marketplace (Amazon Machine Image)
DataMasque está disponible como una AMI preconstruida en AWS Marketplace. Los usuarios pueden lanzar rápidamente la solución en una instancia de EC2 usando una prueba gratuita, opciones Bring-Your-Own-License (BYOL) o esquemas de precios flexibles por hora/mes. Esto la hace accesible tanto para evaluaciones de corto plazo como para implementaciones de largo plazo dentro de flujos de trabajo en la nube.
Integración con EC2 Image Builder
Para organizaciones que crean y actualizan instancias de EC2 de forma regular, DataMasque puede integrarse en el pipeline de EC2 Image Builder. Esto permite el enmascaramiento automatizado de datos como parte de la creación de imágenes, ayudando a estandarizar entornos seguros en implementaciones de desarrollo o prueba.
2. Descubrimiento de datos y conjuntos de reglas
Descubrimiento de datos sensibles
DataMasque escanea automáticamente bases de datos y archivos conectados para identificar datos sensibles. Incluye reglas de detección integradas para tipos de datos comunes, incluidos nombres, correos electrónicos, identificaciones gubernamentales, números de teléfono, números de tarjeta de crédito e información de salud. Además, los usuarios pueden definir patrones personalizados para cumplir requisitos regulatorios o de negocio específicos.
Creación y uso de conjuntos de reglas
Una vez identificados los campos sensibles, las reglas de enmascaramiento se configuran mediante conjuntos de reglas basados en YAML. Estos conjuntos de reglas especifican qué columnas o campos deben enmascararse y qué métodos de enmascaramiento aplicar. Los conjuntos de reglas son reutilizables, con control de versiones, y pueden usarse en múltiples entornos para una protección consistente en todos los entornos.
Motor de enmascaramiento y tipos de enmascaramiento
DataMasque admite una variedad de técnicas de enmascaramiento irreversibles para garantizar la privacidad de los datos manteniendo la usabilidad. SHA‑512 Salted Hash convierte los valores originales en hashes fijos no reversibles. Randomization & Frequency-Based Masking genera nuevos valores que imitan la distribución estadística de los datos originales.
Las reglas de retención de fechas desplazan o aleatorizan fechas mientras preservan intervalos o secuencias.
Las máscaras basadas en opciones reemplazan valores con entradas de una lista o patrón predefinido, útil para campos como nombres de departamentos o regiones.
Cada técnica se selecciona según el tipo de dato y el caso de uso, garantizando el cumplimiento sin interrumpir los flujos de trabajo del negocio.
3. Mantener la integridad
Para garantizar que los datos enmascarados sigan siendo funcionalmente válidos, DataMasque preserva la integridad referencial y las relaciones de datos. DataMasque puede enmascarar identificadores como IDs de clientes manteniendo la unicidad.
Garantiza que las relaciones de claves foráneas (p. ej., IDs de usuario vinculados en múltiples tablas) permanezcan intactas, lo que permite que las aplicaciones y consultas sigan funcionando correctamente con datos enmascarados. Esta función es crítica para equipos de desarrollo, pruebas y analítica que dependen de conjuntos de datos consistentes e interconectados.
Casos de uso prácticos y valor de negocio de DataMasque en AWS
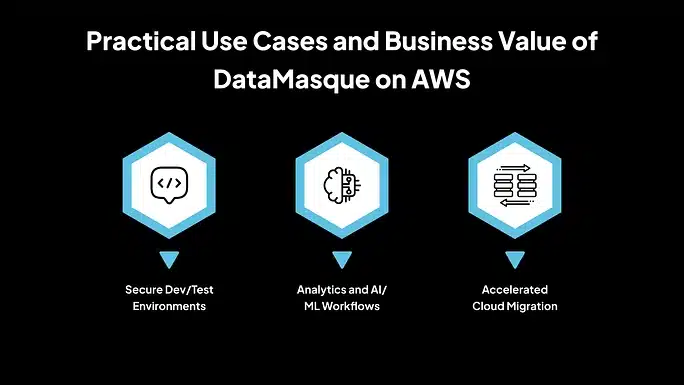
DataMasque ofrece una solución práctica para gestionar de forma segura datos sensibles en diversos entornos en la nube. A continuación se presentan los casos de uso esenciales que demuestran cómo las organizaciones se benefician de sus capacidades de enmascaramiento, especialmente dentro del ecosistema de AWS.
1. Entornos de desarrollo/pruebas seguros
Una de las aplicaciones más comunes de DataMasque es permitir que los equipos de desarrollo y pruebas trabajen con datos que reflejen condiciones reales de producción, sin exponer información sensible real.
Los desarrolladores y equipos de control de calidad a menudo requieren acceso completo a las estructuras de base de datos y relaciones de datos para depurar o validar funcionalidades. Usar datos de producción sin enmascarar en estos entornos crea un riesgo de seguridad y viola los estándares de cumplimiento.
Con DataMasque, las organizaciones pueden generar conjuntos de datos enmascarados funcionalmente precisos que preservan el formato y la estructura, lo que permite realizar pruebas realistas sin comprometer la privacidad de los datos. Esto mejora la eficiencia del desarrollo y reduce los riesgos legales y de seguridad.
2. Flujos de trabajo de analítica e IA/ML
Las organizaciones usan cada vez más datos sensibles para impulsar dashboards, pipelines de analítica y modelos de machine learning. DataMasque les permite hacerlo sin exponer datos personales sin procesar.
Los científicos de datos y analistas pueden trabajar con datos enmascarados sintéticamente idénticos que reflejan patrones y distribuciones reales. Esto garantiza que los modelos predictivos y los análisis estadísticos sigan siendo válidos, al tiempo que se cumple con leyes de protección de datos, como GDPR o HIPAA.
Los equipos de inteligencia empresarial pueden generar reportes y dashboards precisos basados en conjuntos de datos enmascarados, incluso sin acceso a PII sin procesar. Esto permite la extracción segura de insights y el entrenamiento de modelos de manera consciente de la privacidad.
3. Migración acelerada a la nube
Durante la migración a la nube, transferir datos de producción sin procesar a servicios en la nube como Amazon RDS o Amazon S3 introduce desafíos de cumplimiento y seguridad.
DataMasque puede implementarse para enmascarar datos sensibles antes o durante el proceso de migración.
Esto garantiza que se migren conjuntos de datos enmascarados, reduciendo el riesgo de exposición accidental o filtraciones durante la transición.
Las organizaciones pueden avanzar más rápido mientras cumplen simultáneamente con los estándares internos de gobernanza de datos. Esto es beneficioso para organizaciones sujetas a auditorías o leyes internacionales de residencia de datos.
Best Western® Hotels & Resorts implementó DataMasque para mejorar la seguridad de los datos y la agilidad en sus operaciones de TI. Antes de DataMasque, sus entornos de desarrollo y prueba a menudo enfrentaban retrasos debido a procesos manuales prolongados de sanitización de datos.
Después de adoptar DataMasque en AWS, pudieron reducir significativamente el tiempo de enmascaramiento.
Los conjuntos de datos enmascarados conservaron la lógica de negocio y la integridad referencial, lo que permitió que sus desarrolladores probaran nuevas funcionalidades con mayor confianza. Esto condujo a ciclos de innovación más rápidos, al tiempo que se garantizaba el cumplimiento de las regulaciones de privacidad.
Mejores prácticas para implementar y operar DataMasque en AWS
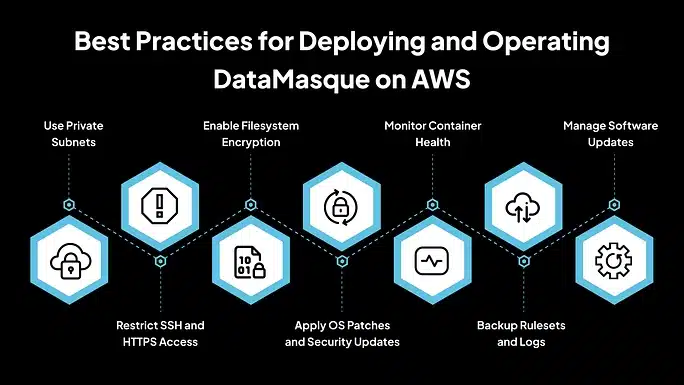
Antes de implementar DataMasque en AWS, deben estar en su lugar los siguientes componentes:
|
Para garantizar el uso seguro y eficiente de DataMasque en AWS, es esencial seguir ciertos requisitos previos y lineamientos operativos. Estas prácticas ayudan a mantener la privacidad de los datos, la estabilidad del sistema y el rendimiento a largo plazo en los flujos de trabajo de enmascaramiento.
1. Usa subredes privadas
Implementa las instancias de EC2 que alojan DataMasque dentro de subredes privadas en tu Virtual Private Cloud (VPC). Esto limita la exposición de la instancia a internet público y reduce la superficie de ataque, garantizando que solo servicios internos o endpoints confiables puedan acceder al entorno.
2. Restringe el acceso SSH y HTTPS
Restringe el acceso a SSH (puerto 22) y HTTPS (puerto 443) configurando reglas de grupos de seguridad de AWS. Limita el acceso a direcciones IP o rangos específicos, como solo tu red interna o un bastion host designado. Esto minimiza el potencial de acceso externo no autorizado.
3. Habilita el cifrado del sistema de archivos
Habilita el cifrado de volúmenes de Amazon EBS en la instancia de EC2 utilizada por DataMasque. Esto protege todos los datos almacenados en disco, incluidos los datos temporales y enmascarados en reposo, usando claves administradas por AWS o claves administradas por el cliente a través de AWS Key Management Service (KMS).
4. Aplica parches del SO y actualizaciones de seguridad
Actualiza regularmente el sistema operativo de la instancia de EC2 para aplicar los parches y correcciones de seguridad más recientes. Esto garantiza protección contra vulnerabilidades conocidas y mantiene el cumplimiento con las políticas de seguridad de TI. Usa herramientas de automatización como AWS Systems Manager Patch Manager para mayor eficiencia.
5. Monitorea la salud del contenedor
Monitorea continuamente el contenedor de Docker que ejecuta DataMasque para asegurarte de que funcione correctamente. Herramientas como Amazon CloudWatch pueden ayudar a detectar problemas de rendimiento, fallas del servicio o agotamiento de recursos, permitiendo una resolución y troubleshooting proactivos.
6. Respaldar conjuntos de reglas y logs
Mantén respaldos regulares de los conjuntos de reglas YAML y los logs de enmascaramiento en una ubicación segura y centralizada, como un bucket de Amazon S3 cifrado o un repositorio con control de versiones. Esta práctica respalda trazabilidad para auditorías, recuperación ante desastres y reutilización de configuraciones entre entornos.
7. Gestiona actualizaciones de software
Mantén el software de DataMasque actualizado revisando nuevas versiones y aplicando actualizaciones según sea necesario. Las actualizaciones regulares garantizan acceso a las funciones más recientes, correcciones de errores y mejoras de seguridad, reduciendo el riesgo de vulnerabilidades relacionadas con el software.
Enmascaramiento de datos estructurados vs. a nivel de documento en AWS: ¿cuál es el adecuado para ti?
A medida que más organizaciones migran cargas de trabajo a AWS, gestionar datos sensibles en servicios en la nube se ha convertido en una prioridad principal. Sin embargo, no todos los datos se ven igual; las bases de datos estructuradas, los documentos no estructurados y los resultados generados por IA requieren enfoques diferentes para la protección de datos.
Si bien las herramientas de enmascaramiento de datos estructurados como DataMasque están diseñadas para proteger bases de datos relacionales y preservar la integridad de los datos para pruebas y analítica, no están hechas para manejar el creciente volumen de contenido no estructurado, incluidos archivos, correos electrónicos, PDFs o resultados en tiempo real de modelos de IA. Ahí es donde soluciones como Data Masker de Avahi ofrecen una alternativa más inteligente y adaptable.
1. Enmascaramiento de datos estructurados con DataMasque
DataMasque está diseñado específicamente para datos estructurados y semiestructurados, como bases de datos relacionales, archivos JSON y exportaciones CSV. Se destaca en:
- Descubrir datos sensibles usando reglas de detección integradas y personalizadas
- Aplicar técnicas de enmascaramiento irreversibles preservando las relaciones de datos
- Mantener la integridad referencial en tablas y entornos interconectados
- Respaldar flujos de trabajo de desarrollo y pruebas con datos enmascarados sintéticamente precisos
Esto hace que DataMasque sea una opción sólida para organizaciones que buscan proteger registros de bases de datos durante desarrollo/pruebas, control de calidad o migración de datos.
Sin embargo, sus capacidades se enfocan principalmente en entornos de datos estructurados. No admite de forma nativa el enmascaramiento de documentos, archivos de imagen, correos electrónicos o contenido generado por IA, brechas que son cada vez más relevantes en los ecosistemas de datos actuales.
2. Enmascaramiento a nivel de documento y no estructurado con Avahi
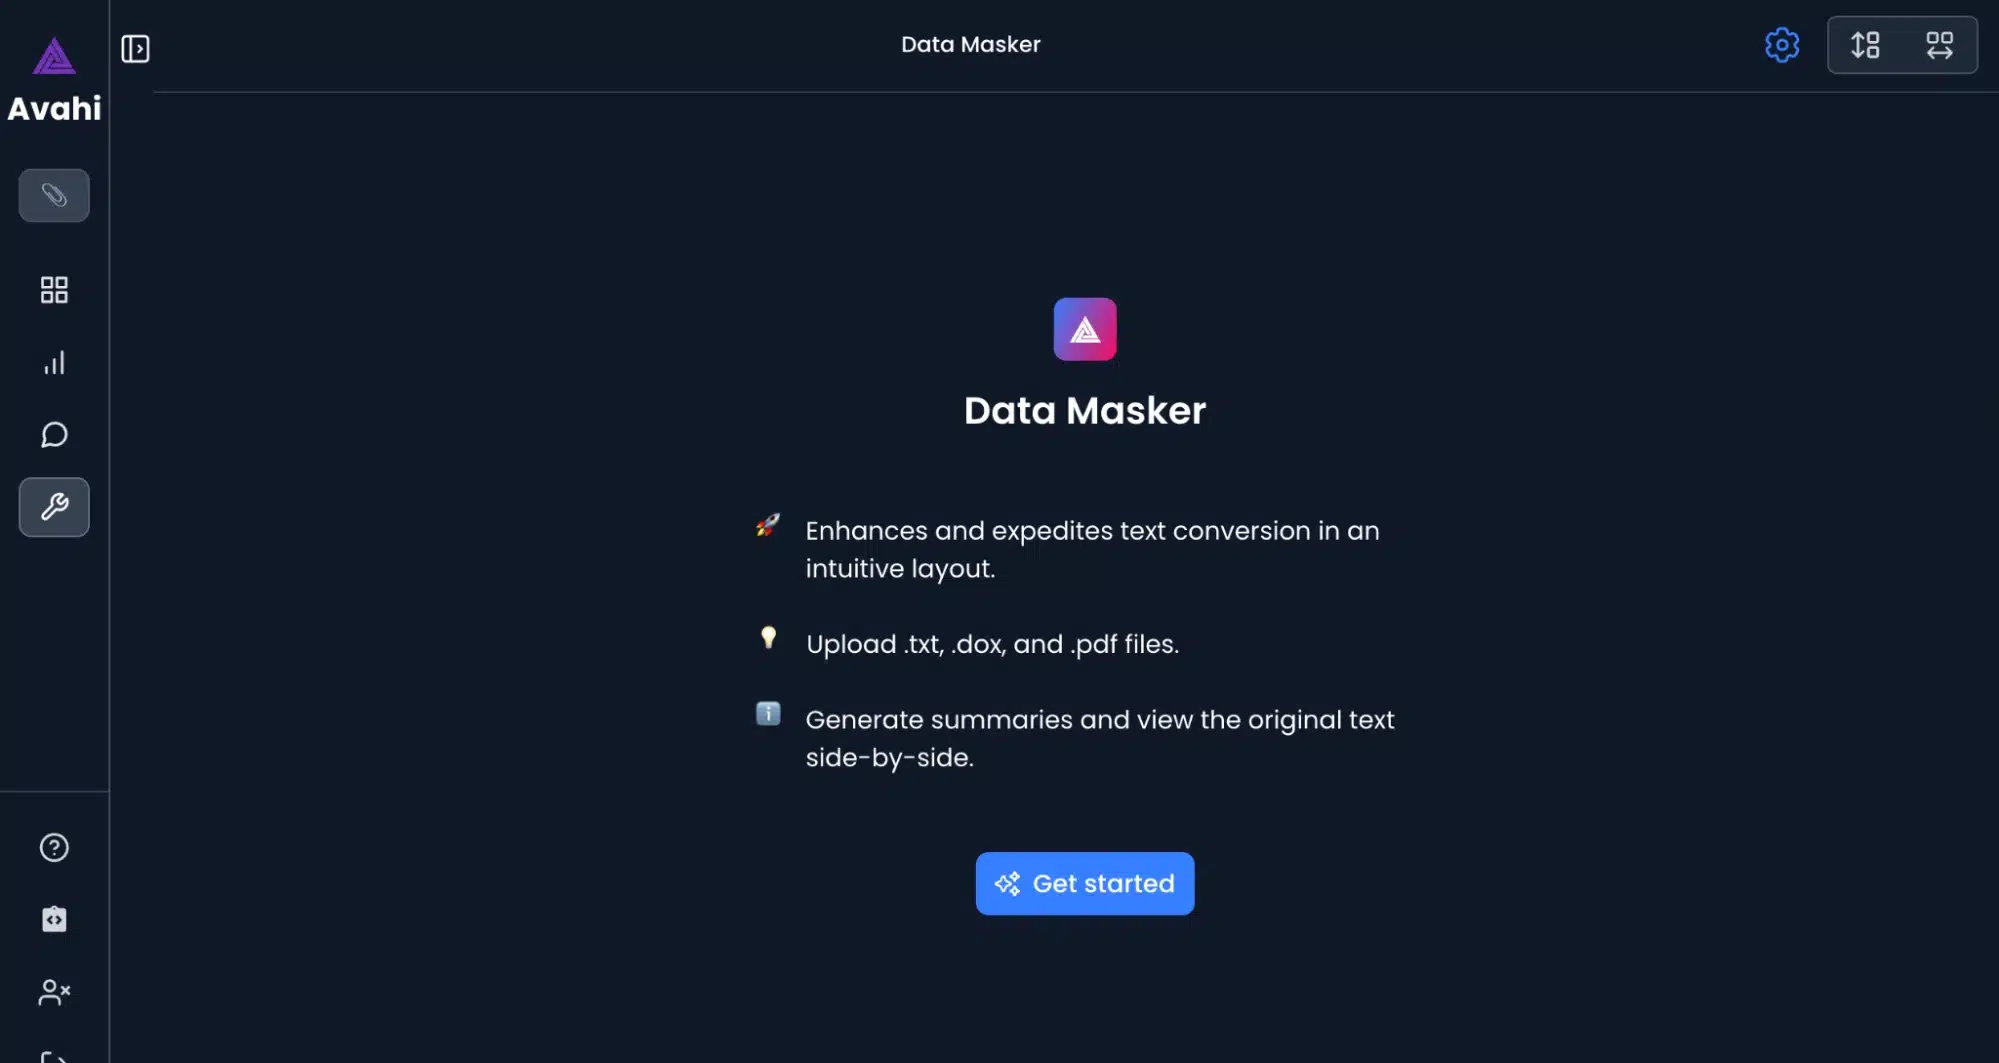
Data Masker de Avahi aborda de frente el desafío de los datos no estructurados. Integrado en la plataforma de IA de Avahi, está diseñado para proteger información sensible que no vive en bases de datos, sino que fluye a través de documentos, canales de comunicación y resultados de GenAI.
Las capacidades esenciales incluyen:
- Enmascaramiento y redacción en tiempo real de PII, PHI y datos financieros en archivos Word, PDF e imágenes
- Integración fluida con herramientas de Microsoft Office, CRMs y repositorios de datos compartidos
- Detección impulsada por GenAI para limpiar contenido sensible en documentos generados por IA, logs de chat y resúmenes
- Controles de acceso basados en roles, garantizando que solo usuarios autorizados accedan a datos reales o enmascarados
- Soporte de cumplimiento para GDPR, HIPAA y PCI DSS sin interrumpir los flujos de trabajo internos
Donde otras herramientas de enmascaramiento se detienen en conjuntos de datos estructurados, Avahi continúa el recorrido de protección a través de documentos, correos electrónicos y contenido dinámico, convirtiéndose en la solución ideal para la privacidad en la era de la IA y la colaboración en la nube.
Al seleccionar una solución de enmascaramiento de datos, es importante considerar dónde reside tu información sensible y cómo tus equipos interactúan con ella. Si trabajas con grandes volúmenes de registros estructurados, como IDs de clientes, transacciones o conjuntos de datos de prueba, DataMasque puede ser una excelente opción.
Pero supongamos que tus datos viven en documentos, formularios, archivos o resultados de GenAI, o fluyen a través de plataformas de comunicación y colaboración. En ese caso, Data Masker de Avahi ofrece la precisión, flexibilidad y protección en tiempo real que las organizaciones modernas necesitan.
Simplifica la protección de datos con la solución de enmascaramiento de datos impulsada por IA de Avahi
En Avahi, reconocemos la importancia crucial de proteger la información sensible mientras mantenemos flujos de trabajo operativos sin fricciones.
Con Data Masker de Avahi, tu organización puede proteger fácilmente datos confidenciales, desde salud hasta finanzas, manteniendo el cumplimiento normativo con estándares como HIPAA, PCI DSS y GDPR.
Nuestra solución de enmascaramiento de datos combina técnicas avanzadas impulsadas por IA con control de acceso basado en roles para mantener tus datos seguros y utilizables para desarrollo, analítica y detección de fraude.
Ya sea que necesites anonimizar registros de pacientes, transacciones financieras o identificadores personales, Data Masker de Avahi ofrece un enfoque intuitivo y seguro para la protección de datos.
¿Listo para proteger tus datos y garantizar el cumplimiento? ¡Comienza con Data Masker de Avahi!
Programar una llamada de demostración
Preguntas frecuentes
1. ¿Qué es el enmascaramiento de datos en AWS y por qué es importante?
El enmascaramiento de datos en AWS es el proceso de ofuscar datos sensibles (como PII o PHI) almacenados en entornos de AWS para evitar accesos no autorizados. Es esencial para mantener la privacidad de los datos, habilitar pruebas y analítica seguras, y garantizar el cumplimiento con regulaciones como GDPR, HIPAA y PCI DSS.
2. ¿Cómo realiza DataMasque el enmascaramiento de datos en AWS?
DataMasque funciona escaneando fuentes de datos estructurados alojadas en AWS, como Amazon RDS, archivos en S3 o bases de datos en EC2, y aplicando técnicas de enmascaramiento irreversibles mientras preserva la integridad referencial. Usa conjuntos de reglas basados en YAML y admite la implementación mediante una AMI de AWS Marketplace.
3. ¿Puede DataMasque manejar datos no estructurados o documentos en AWS?
No. DataMasque está diseñado principalmente para formatos de datos estructurados y semiestructurados (p. ej., SQL, JSON, CSV). No admite el enmascaramiento de PDFs, documentos de Word, correos electrónicos o contenido generado por IA.
4. ¿Qué herramienta es mejor para el enmascaramiento de datos a nivel de documento en AWS?
Para el enmascaramiento de datos no estructurados, como la redacción de información sensible en PDFs, DOCX, correos electrónicos o resultados de GenAI, Data Masker de Avahi es una mejor opción. Usa detección impulsada por GenAI y redacción con un clic para proteger datos en documentos y flujos de archivos dentro de AWS.
5. ¿Se requiere el enmascaramiento de datos en AWS para cumplir con GDPR o HIPAA?
Sí. Tanto GDPR como HIPAA exigen que las organizaciones limiten la exposición de datos personales. El enmascaramiento de datos ayuda a cumplir esas obligaciones al garantizar que los datos sensibles se anonimicen en entornos que no son de producción o durante el intercambio externo de datos.