

TL;DR
|
En 2023, HCA Healthcare, un importante sistema hospitalario de EE. UU., sufrió una filtración de datos que expuso la información personal de más de 11 millones de pacientes. Los datos filtrados incluían detalles de citas, información de contacto y registros de servicios al paciente.
Unos años antes, Anthem Inc. se enfrentó a una de las mayores filtraciones de la historia del sector sanitario. Casi 80 millones de registros, incluidos nombres, identificaciones médicas e información laboral, se vieron comprometidos.
Las organizaciones sanitarias son objetivos atractivos para los ciberataques debido a la gran cantidad de datos confidenciales que manejan. Los historiales médicos electrónicos (HME), la información de facturación, los detalles de los seguros y los identificadores personales constituyen conjuntos de datos de gran valor que, si se exponen, pueden dar lugar a robo de identidad, fraude de seguros y sanciones reglamentarias.
El creciente uso de la IA en la atención sanitaria ha traído nuevas oportunidades para diagnósticos más inteligentes, análisis predictivos y eficiencia operativa. Al mismo tiempo, ha aumentado lo que está en juego para la seguridad de los datos.
Los sistemas de IA dependen de grandes volúmenes de datos de pacientes para funcionar eficazmente, pero estos datos deben protegerse en cada etapa. A medida que la información fluye entre departamentos, sistemas en la nube y herramientas de terceros, el riesgo de exposición aumenta.
El enmascaramiento de datos es una solución compatible con la IA para el sector sanitario que protege la información confidencial sin interrumpir la usabilidad. Al sustituir los datos precisos por valores realistas pero no identificables, el enmascaramiento de datos garantiza que los historiales de los pacientes sigan siendo privados, incluso si acceden a ellos usuarios no autorizados.
Este blog explora el enmascaramiento de datos: qué es, cómo funciona y por qué es una defensa crucial frente a la creciente amenaza de una filtración de datos en el sector sanitario.
El impacto de una filtración de datos en el sector sanitario
Los datos sanitarios son extremadamente valiosos en la dark web. A diferencia de los números de tarjetas de crédito, que pueden cancelarse rápidamente, la información de salud personal (PHI) incluye datos permanentes, nombres completos, fechas de nacimiento, números de Seguro Social, detalles del seguro e historiales médicos. Esta información suele venderse a un precio más alto porque puede utilizarse para el robo de identidad, el fraude de seguros y el chantaje. A continuación se muestran las consecuencias a las que se enfrentan las organizaciones sanitarias tras una filtración de datos.
Presión regulatoria
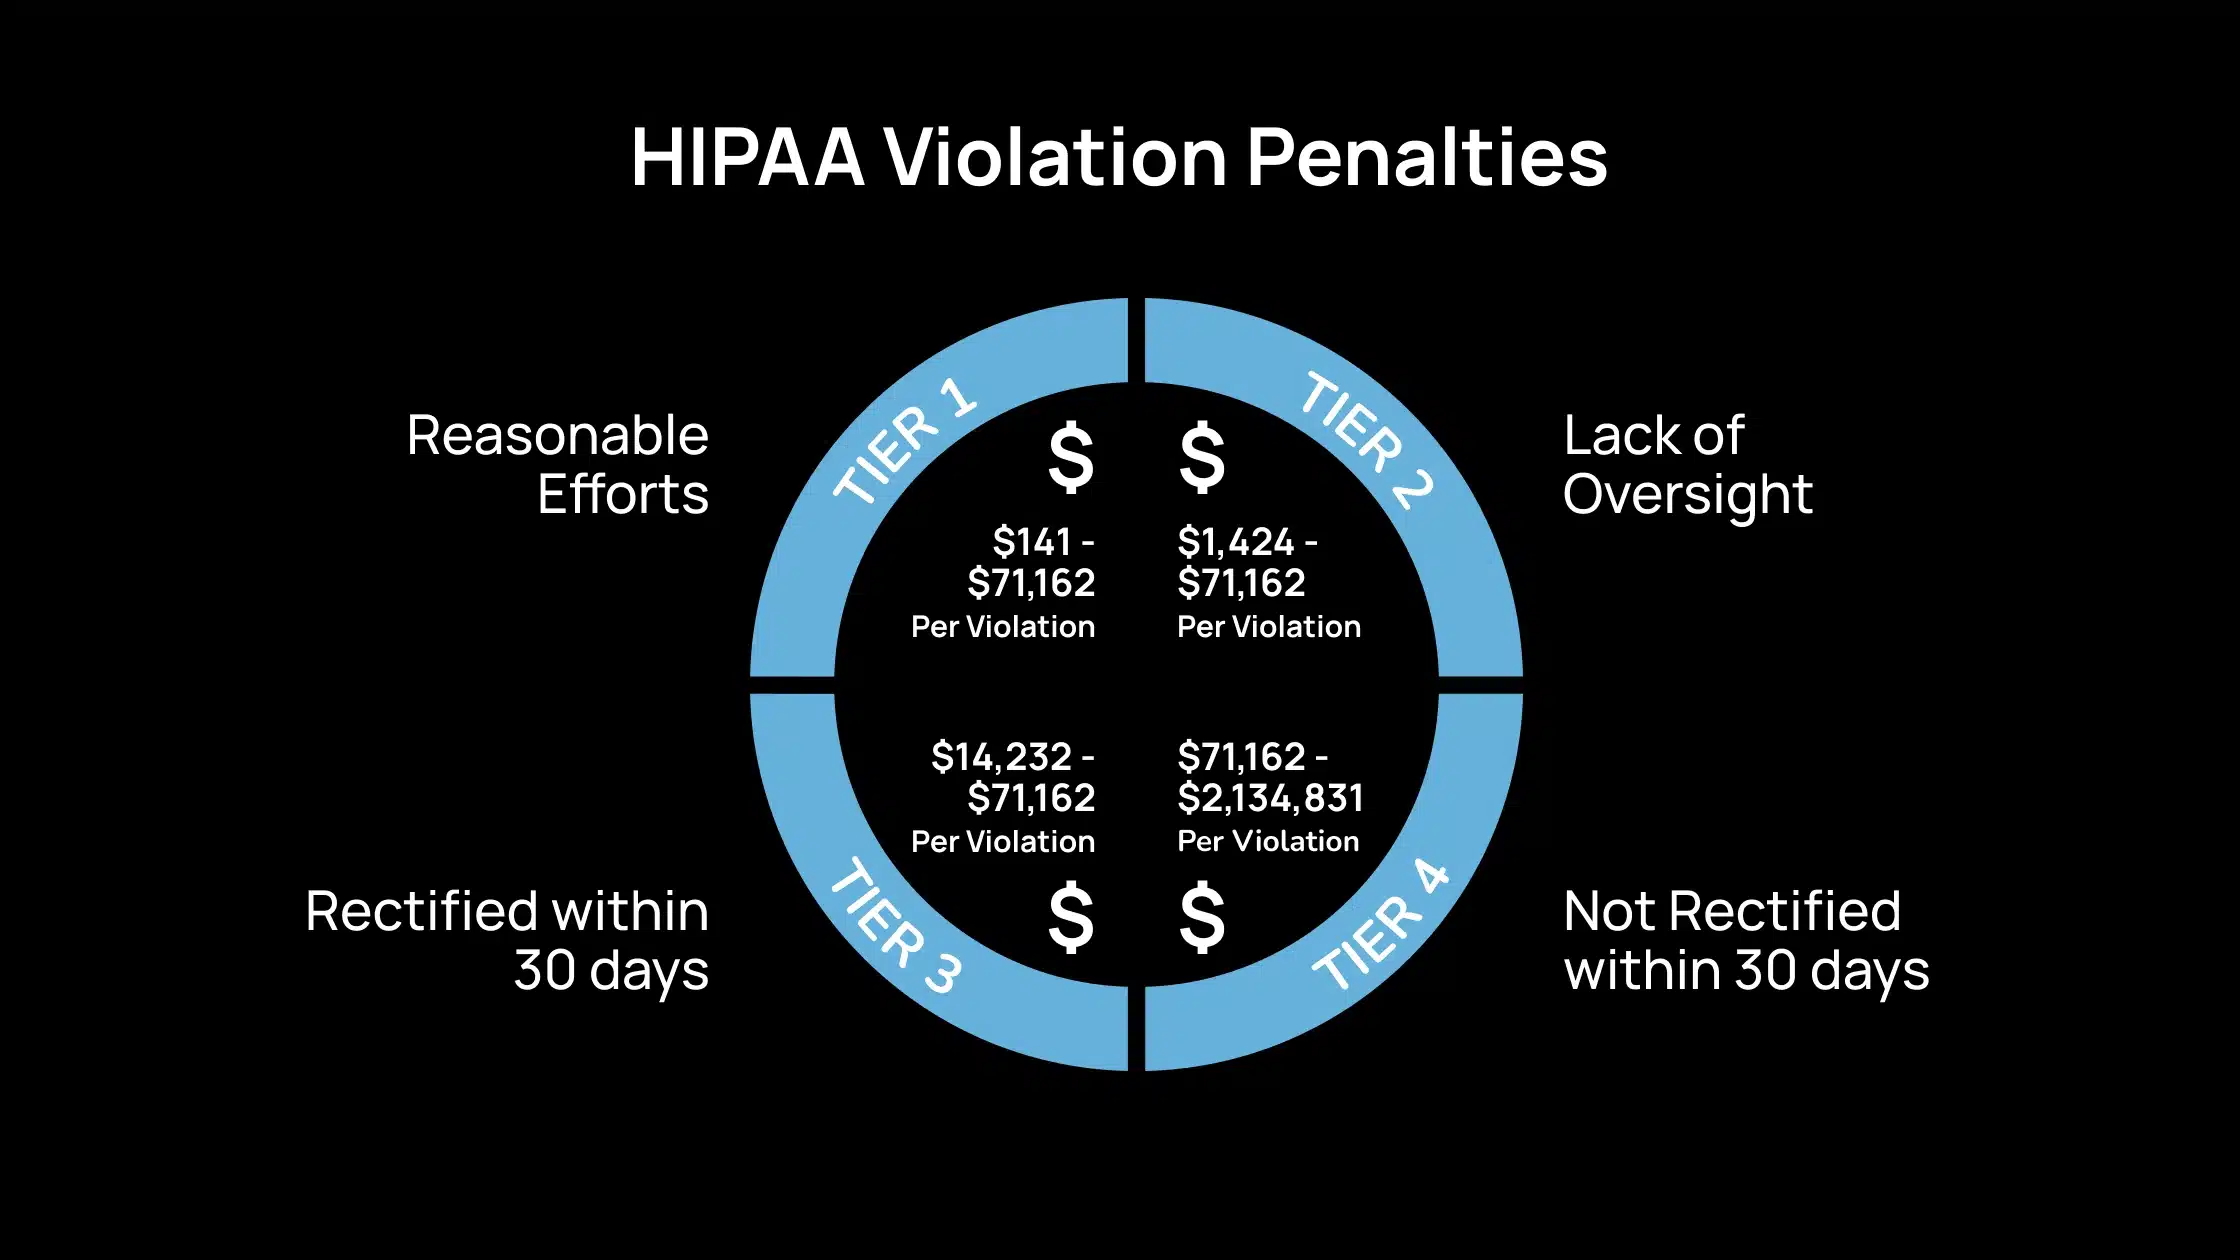
Las organizaciones sanitarias se enfrentan a estrictos requisitos de cumplimiento en virtud de las regulaciones HIPAA (Health Insurance Portability and Accountability Act) en EE. UU. y el GDPR (General Data Protection Regulation) en la UE. Estas leyes exigen el manejo seguro de los datos personales, la notificación rápida de filtraciones y pruebas de salvaguardas adecuadas. El incumplimiento puede dar lugar a fuertes multas y desafíos legales.
Erosión de la confianza del paciente
Una filtración de datos puede provocar una pérdida inmediata de la confianza del paciente. Los pacientes esperan que sus historiales médicos sean privados. Cuando los datos quedan expuestos, se daña la reputación del proveedor de atención sanitaria y los pacientes dudan en compartir información confidencial en el futuro.
Sanciones financieras
Los organismos reguladores imponen importantes multas a las organizaciones sanitarias por fallas de seguridad, en particular por violaciones de la Health Insurance Portability and Accountability Act (HIPAA). La estructura de sanciones se escalona en función del nivel de culpabilidad:
Implicaciones legales
Las organizaciones pueden enfrentarse a demandas de los pacientes afectados, especialmente si se demuestra que no existían las salvaguardas adecuadas. Las demandas colectivas son comunes y las batallas legales pueden durar años, lo que aumenta el costo financiero y reputacional. Por ejemplo, Anthem Inc. llegó a un acuerdo por $115 millones tras una filtración que expuso casi 80 millones de registros.
Tiempo de inactividad operativa
Responder a una filtración suele implicar apagar sistemas, realizar investigaciones forenses y restaurar respaldos de datos. Esto puede interrumpir la atención al paciente, retrasar tratamientos y tensionar los recursos del personal.
Cuanto más largo sea el tiempo de inactividad, mayor será el riesgo para los resultados de los pacientes y la continuidad del negocio. Los ataques de ransomware han provocado un promedio de casi 19 días de inactividad en organizaciones sanitarias de EE. UU., lo que subraya las graves interrupciones operativas causadas por este tipo de incidentes.
Enmascaramiento de datos: propósito, proceso y tipos
El enmascaramiento de datos ayuda a reducir el riesgo de una filtración de datos en el sector sanitario al sustituir la información real del paciente por datos realistas pero ficticios, garantizando que los detalles confidenciales permanezcan protegidos incluso si se produce un acceso no autorizado.
La idea principal es mantener el formato y la usabilidad de los datos para que las operaciones del negocio y el rendimiento del sistema no se vean afectados. Por ejemplo, el nombre de un paciente puede sustituirse por un nombre falso, pero seguirá pareciendo un nombre y encajará en el mismo sistema.
Aquí tienes una explicación detallada de cada uno de los tipos de enmascaramiento de datos:
Enmascaramiento de datos estático
El enmascaramiento de datos estático se realiza sobre una copia de una base de datos. Los datos originales se enmascaran una vez y se guardan en un nuevo entorno. Este método se utiliza comúnmente en entornos que no son de producción, como desarrollo o pruebas, donde no es necesario acceder a datos precisos.
Una vez enmascarados, los datos no cambian. Por ejemplo, enmascarar datos en un entorno de pruebas antes de compartirlos con desarrolladores externos.
Enmascaramiento de datos dinámico
El enmascaramiento de datos dinámico oculta los datos confidenciales en tiempo real sin alterar los datos en reposo. Los datos originales permanecen sin cambios en la base de datos, pero los usuarios solo ven la versión enmascarada según su nivel de acceso.
A menudo se utiliza en entornos en vivo donde ciertos usuarios deben ver datos limitados. Por ejemplo, un agente de call center puede acceder a información parcial del paciente mientras se protege el registro completo.
Enmascaramiento determinista
El enmascaramiento determinista garantiza que la misma entrada siempre produzca la misma salida enmascarada. Por ejemplo, “Daniel S” siempre se enmascarará como “Ray Smith”. Esta consistencia es útil cuando es necesario unir o comparar varias bases de datos. Esto ayuda a mantener las relaciones entre registros enmascarados en diferentes sistemas.
Enmascaramiento no determinista
El enmascaramiento no determinista produce resultados diferentes cada vez que se enmascara la misma entrada. Es más seguro, pero puede afectar la usabilidad si se necesitan resultados consistentes. Este método ayuda a enmascarar datos para entornos donde las relaciones entre conjuntos de datos no son importantes.
Enmascaramiento que preserva el formato
El enmascaramiento que preserva el formato mantiene la estructura y el formato originales de los datos. Por ejemplo, un número de Seguro Social enmascarado seguirá el formato de 9 dígitos, y un número de teléfono seguirá pareciendo válido.
Esto garantiza que los datos enmascarados funcionen con sistemas que requieren datos en formatos específicos, como software de HCE o scripts de validación.
Desafíos al implementar el enmascaramiento de datos
Aunque sustituir información confidencial por valores desidentificados suena simple, implementarlo trae desafíos reales. Estos son algunos de los desafíos a los que se enfrentan las organizaciones sanitarias al implementarlo:
- Preservar la usabilidad de los datos
Los datos enmascarados aún deben funcionar. Eso significa que los números de teléfono deben parecer números y las identificaciones médicas deben pasar las comprobaciones del sistema. Si el formato cambia, los sistemas pueden rechazar los datos, romper procesos automatizados o etiquetar mal los registros. Por ejemplo, si una identificación de paciente enmascarada no coincide con los patrones esperados, los sistemas de HCE podrían marcarla como inválida, deteniendo los flujos de trabajo posteriores.
- Mantener la consistencia
Las organizaciones sanitarias suelen usar múltiples bases de datos entre departamentos: clínico, facturación, investigación y soporte. Si el mismo registro de paciente se enmascara de forma diferente en cada sistema, las herramientas internas no pueden vincular los datos de manera confiable. Esto rompe las pruebas, los reportes y la interoperabilidad. El enmascaramiento consistente es clave, pero es difícil cuando los sistemas no están conectados o estandarizados.
- Garantizar la precisión semántica
El enmascaramiento no se trata solo de ocultar datos; debe mantener el significado. Si se cambia una fecha de nacimiento, las alertas basadas en la edad (p. ej., pediátrico o geriátrico) deben reflejar ese cambio. De lo contrario, la lógica integrada en sistemas de analítica, pruebas o toma de decisiones podría fallar o generar resultados engañosos.
- Enmascaramiento de datos sensible al género
Los nombres suelen revelar el género, lo cual importa en investigación sanitaria, analítica de tratamientos y reportes de cumplimiento. Si los nombres se intercambian aleatoriamente durante el enmascaramiento sin preservar el género, puede distorsionar los modelos de datos. Por ejemplo, un equipo de investigación que analiza resultados de tratamiento por género podría sacar conclusiones incorrectas.
- Alinear seguridad y funcionalidad
Si el enmascaramiento es demasiado agresivo, los datos pierden sentido. Si se enmascara muy poco, es un riesgo de privacidad. El desafío es encontrar el punto medio entre proteger los datos del paciente y conservar suficiente detalle para analítica útil, simulaciones y pruebas.
- Adaptarse a sistemas heredados
Los sistemas antiguos pueden no ser compatibles con herramientas modernas de enmascaramiento o integraciones. Los proveedores de atención sanitaria suelen depender de software heredado con estructuras de datos rígidas y flexibilidad limitada. Introducir enmascaramiento en estos entornos requiere soluciones personalizadas, lo que por lo general aumenta el tiempo y el costo de implementación.
- Rendimiento a escala
Aplicar enmascaramiento a conjuntos de datos grandes y en constante crecimiento puede ralentizar las operaciones, especialmente en sistemas en tiempo real. Los hospitales que procesan altos volúmenes de pacientes no pueden permitirse retrasos al acceder o actualizar registros. Si no está bien optimizado, el enmascaramiento dinámico puede introducir latencia en aplicaciones orientadas al usuario.
Aplicaciones reales del enmascaramiento de datos en el sector sanitario
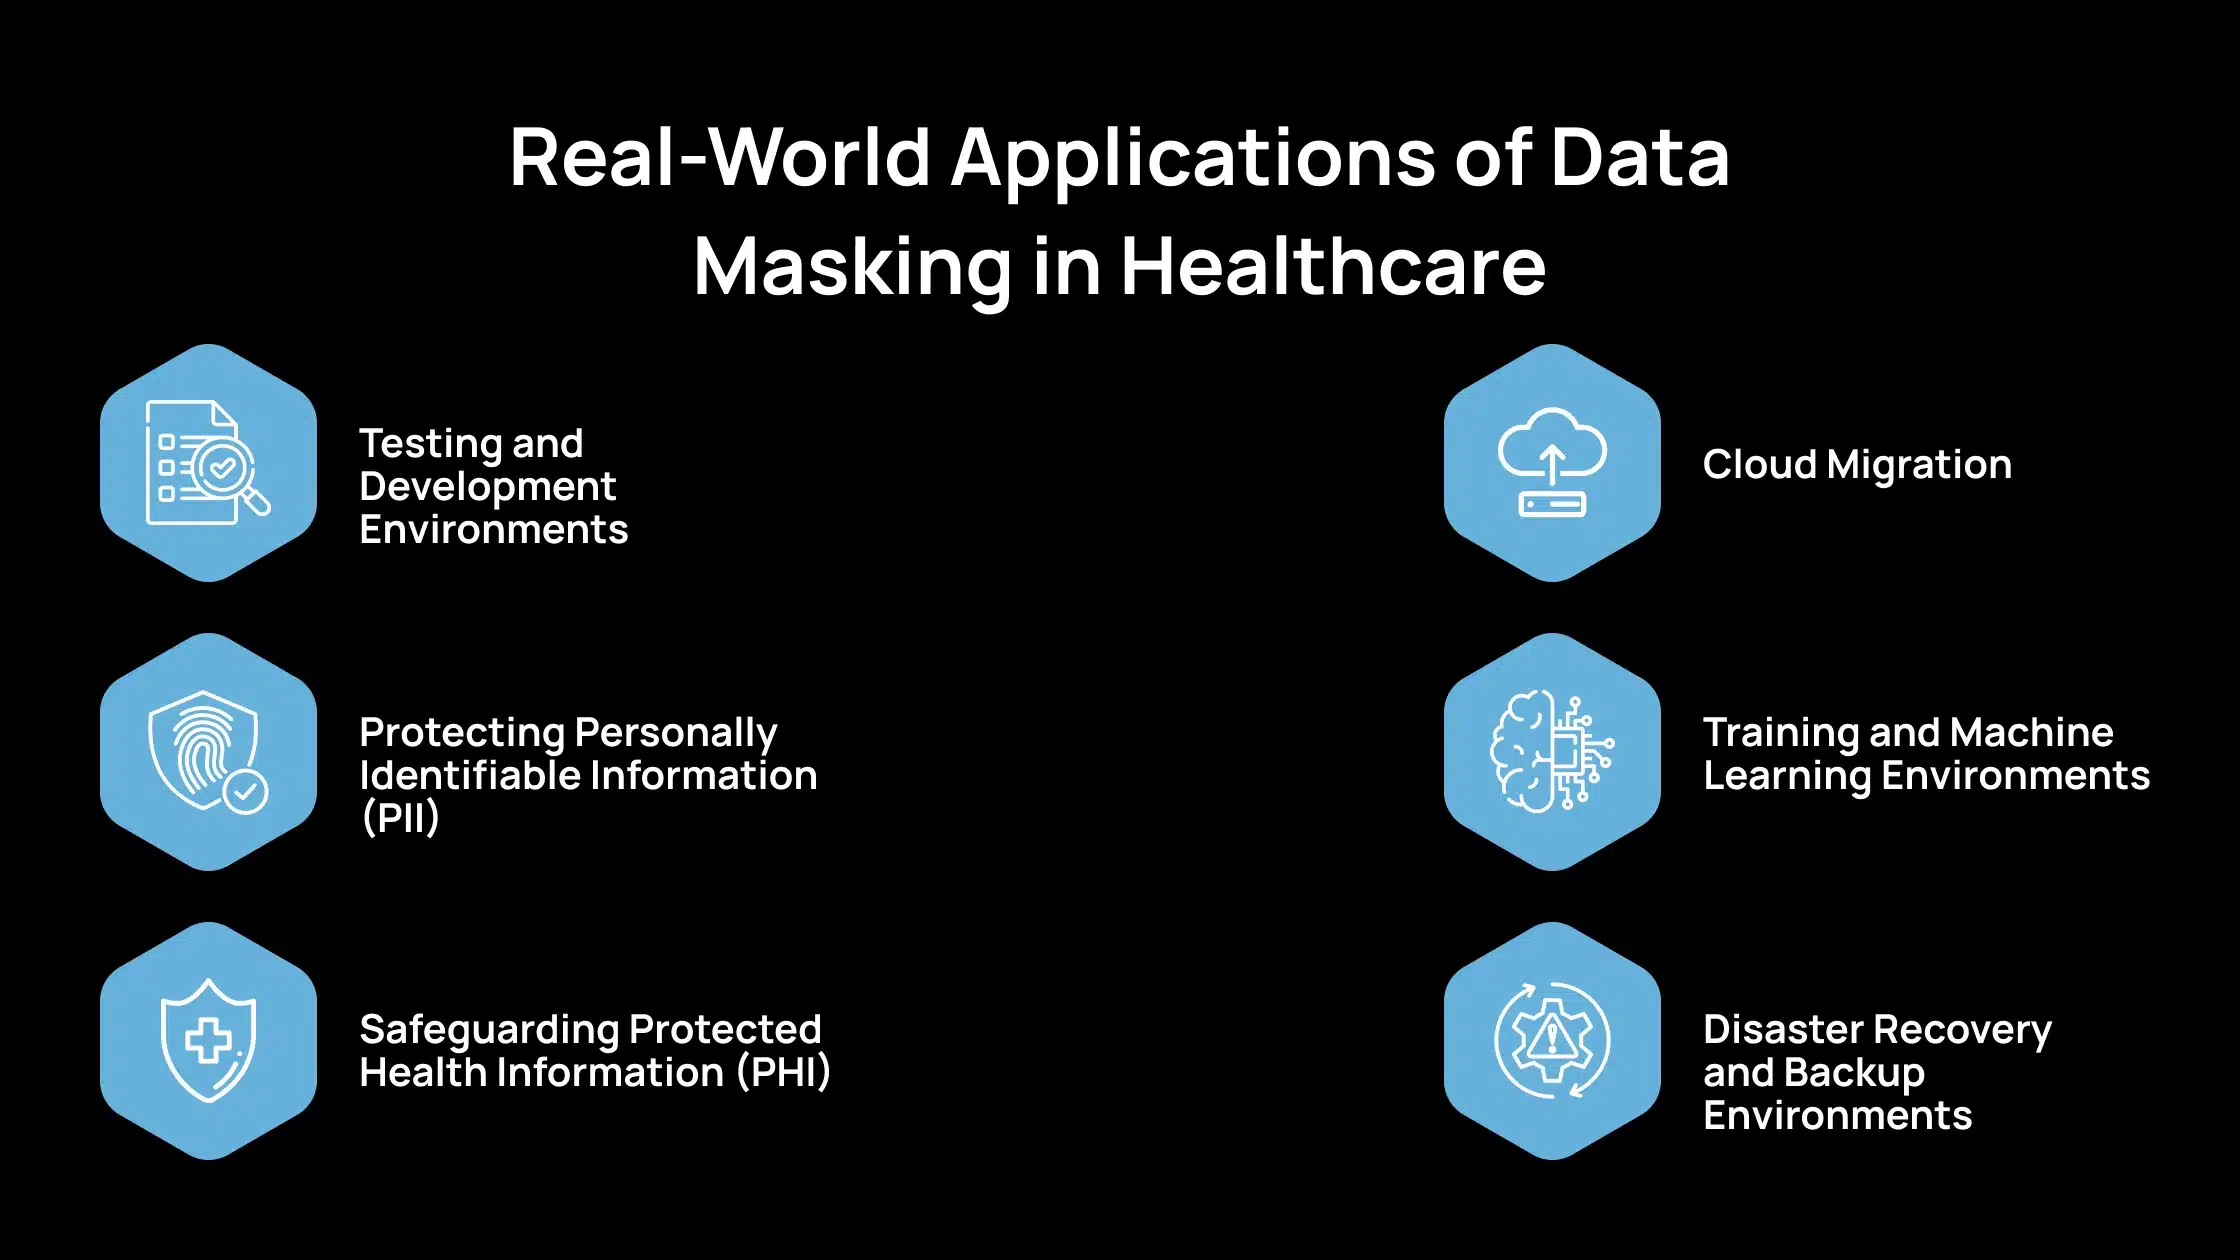
Las organizaciones sanitarias usan el enmascaramiento de datos en sus flujos de trabajo para reducir activamente el riesgo de una filtración de datos en el sector sanitario, manteniendo la eficiencia operativa. Así es como se utiliza el enmascaramiento de datos en los flujos de trabajo sanitarios.
1. Entornos de pruebas y desarrollo
Cuando desarrolladores y testers necesitan acceso a bases de datos de pacientes para actualizaciones del sistema o desarrollo de aplicaciones, exponer datos precisos crea riesgos significativos de privacidad. El enmascaramiento de datos permite a las organizaciones crear versiones realistas pero anonimizadas de los historiales de los pacientes. Estos conjuntos de datos enmascarados mantienen la estructura y la lógica de los datos originales, lo que permite pruebas precisas sin revelar información personal.
2. Proteger la información de identificación personal (PII)
Los sistemas sanitarios almacenan PII como nombres, direcciones, datos de contacto y números de Seguro Social. Enmascarar estos elementos antes de usarlos en entornos no seguros reduce el riesgo de exposición de datos, especialmente cuando varios equipos acceden a los mismos sistemas.
3. Proteger la información de salud protegida (PHI)
Regulaciones como HIPAA exigen que las organizaciones garanticen que los datos de salud del paciente estén debidamente protegidos. El enmascaramiento de datos permite a los proveedores de atención sanitaria compartir PHI para investigación, reportes o analítica, protegiendo al mismo tiempo las identidades de los pacientes. También respalda el cumplimiento durante auditorías y colaboraciones externas.
4. Migración a la nube
A medida que más organizaciones sanitarias se trasladan a plataformas en la nube para almacenamiento y analítica, el enmascaramiento se vuelve esencial. Transferir datos a entornos de terceros aumenta el riesgo de filtraciones. Los proveedores de atención sanitaria pueden reducir la exposición sin interrumpir los plazos de migración al enmascarar los datos confidenciales antes de migrar.
5. Entornos de entrenamiento y machine learning
Cada vez se usan más datos para entrenar modelos de machine learning en el sector sanitario para herramientas de diagnóstico, análisis predictivos y más. Los datos enmascarados que reflejan datos reales de pacientes garantizan que el modelo aprenda de forma eficaz sin comprometer la privacidad ni incumplir los estándares de cumplimiento.
6. Entornos de recuperación ante desastres y respaldos
Los conjuntos de datos de respaldo y recuperación ante desastres suelen contener copias completas de la información del paciente. Si estos entornos no son tan seguros como producción, se convierten en objetivos fáciles para filtraciones. El enmascaramiento garantiza que estos registros no contengan identificadores reales, reduciendo el impacto de cualquier posible fuga.
Beneficios del enmascaramiento de datos para organizaciones sanitarias
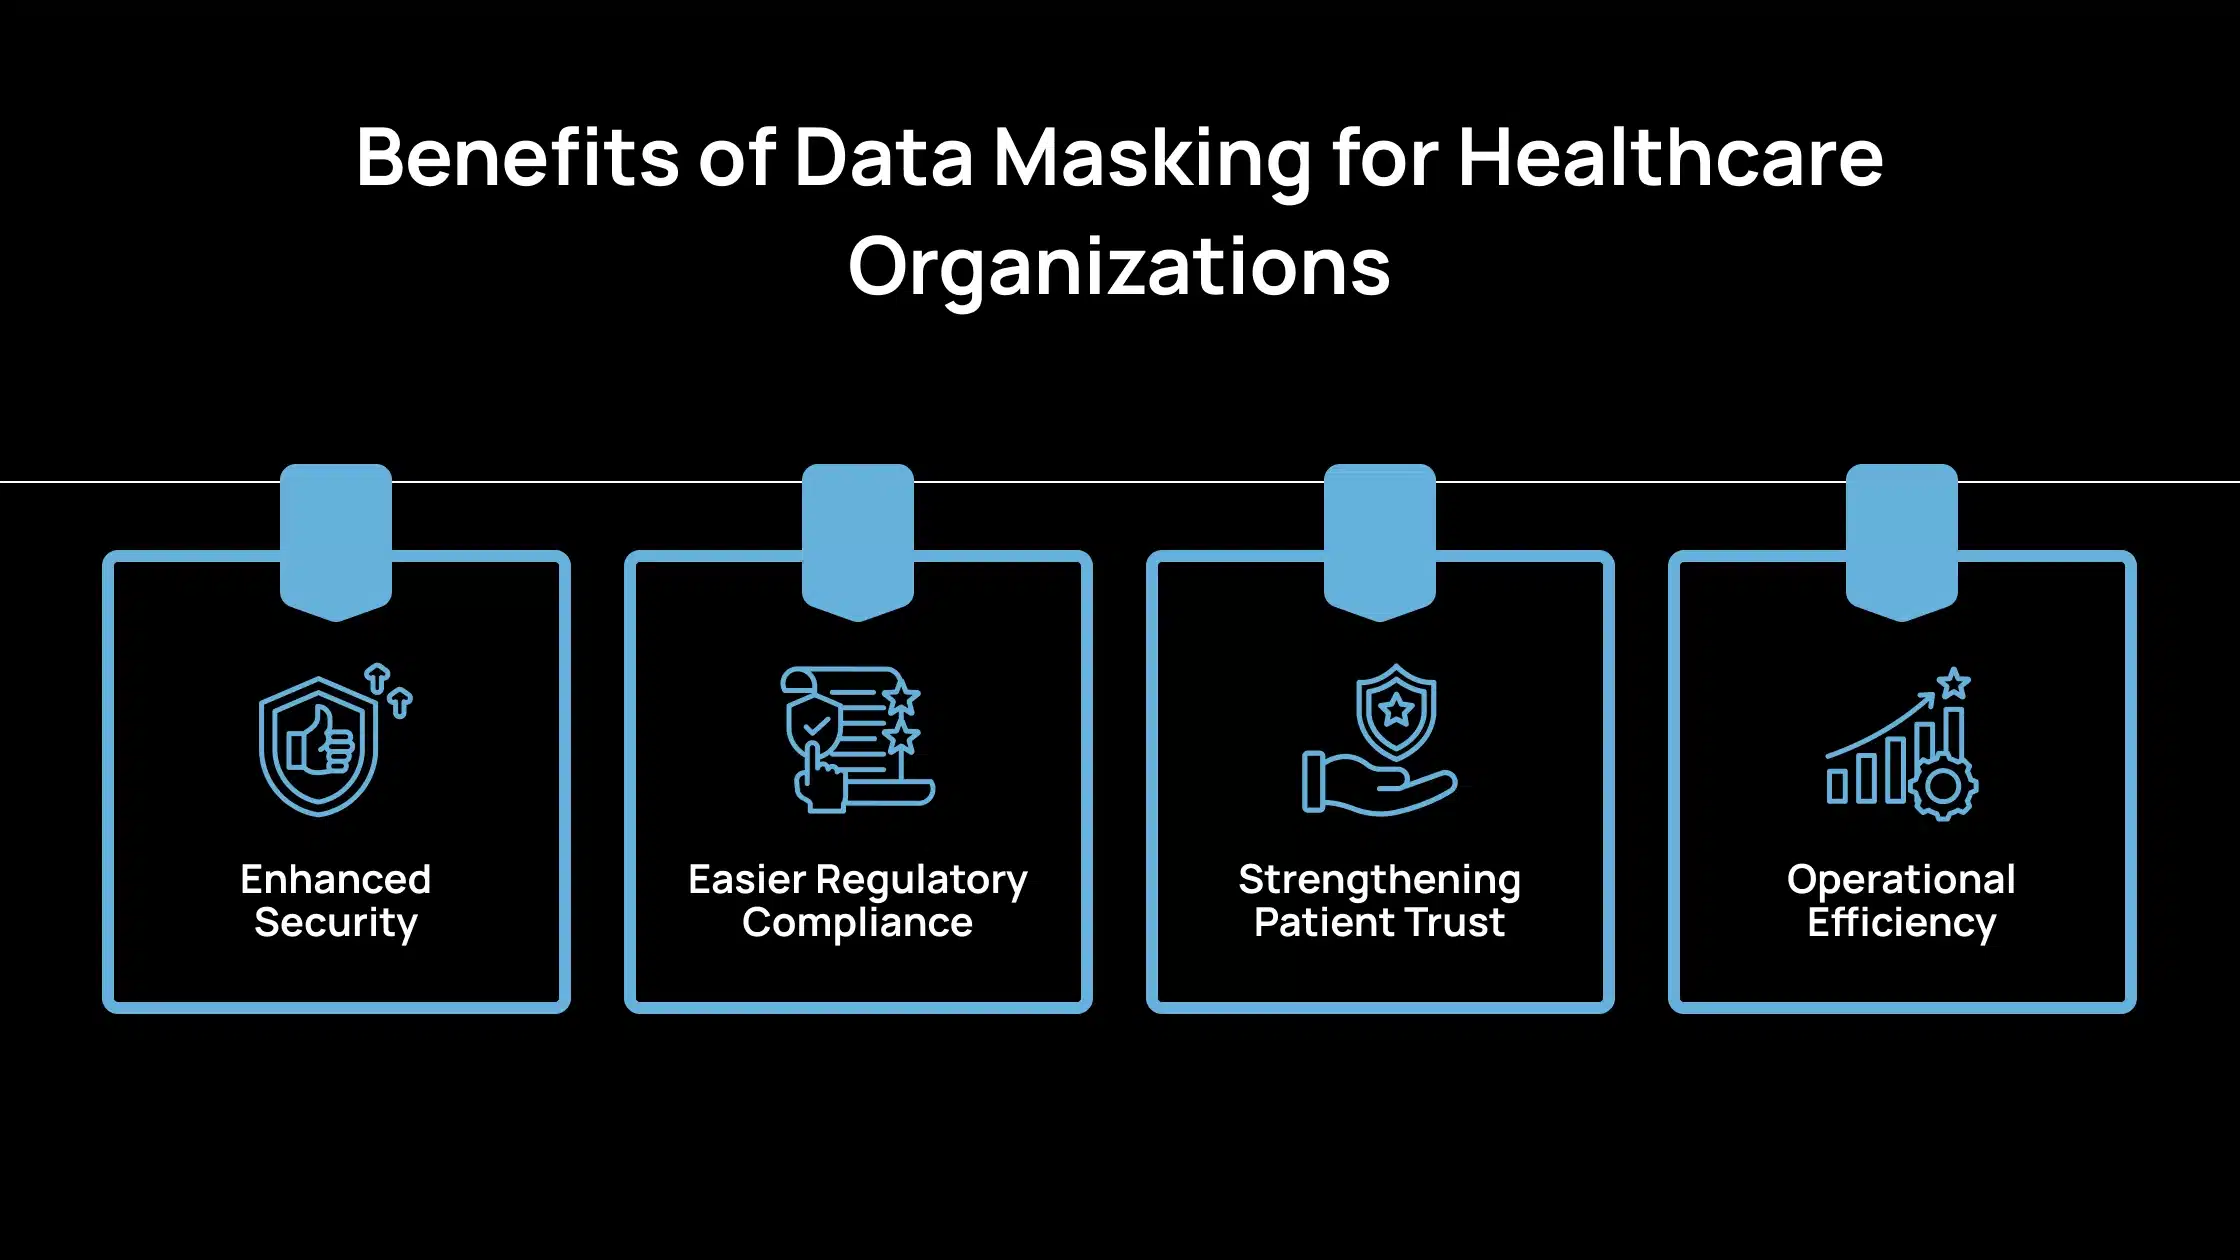
El enmascaramiento de datos permite a los proveedores de atención sanitaria proteger información confidencial sin ralentizar las operaciones. Aquí tienes una lista de algunos beneficios de por qué el enmascaramiento de datos es esencial para las organizaciones:
1. Seguridad mejorada
Los datos enmascarados pueden usarse para desarrollo, pruebas, analítica y entrenamiento sin arriesgar la exposición de información precisa del paciente. Esto garantiza que los equipos puedan trabajar con conjuntos de datos realistas mientras mantienen segura la información de salud protegida (PHI).
El sector sanitario registró el costo promedio más alto por filtración, con $10.93 millones. El enmascaramiento de datos puede reducir significativamente este riesgo al garantizar que los datos expuestos no puedan rastrearse hasta personas reales.
2. Cumplimiento regulatorio más sencillo
El enmascaramiento de datos ayuda a las organizaciones sanitarias a cumplir con requisitos regulatorios estrictos como HIPAA, GDPR y CCPA. Los datos enmascarados suelen considerarse desidentificados, lo que reduce la carga regulatoria cuando se usan en entornos no productivos o de investigación.
3. Fortalecer la confianza del paciente
Cuando los pacientes saben que sus datos se manejan de forma segura, incluso más allá del uso clínico, refuerzan la confianza en el proveedor. El enmascaramiento de datos evita el mal uso o la exposición accidental, especialmente en sistemas sanitarios grandes y distribuidos donde varios equipos acceden a los datos.
Una encuesta de Accenture encontró que 1 de cada 4 pacientes cambiaría de proveedor si sus datos se vieran comprometidos. Medidas sólidas de protección de datos como el enmascaramiento pueden ayudar a retener la lealtad del paciente.
4. Eficiencia operativa
El enmascaramiento de datos permite el uso seguro de datos en distintos flujos de trabajo, como desarrollo de aplicaciones, entrenamiento, analítica y migración a la nube. Reduce la necesidad de barreras de seguridad complejas en entornos que no requieren acceso a datos precisos.
Las organizaciones sanitarias enfrentan amenazas crecientes a los datos de los pacientes todos los días. Al usar el enmascaramiento de datos, pueden proteger información confidencial sin ralentizar su trabajo. El enmascaramiento sustituye datos reales por valores falsos pero realistas, de modo que, incluso si alguien obtiene acceso no autorizado, no verá nada útil. Esto ayuda a cumplir las normas de privacidad y mantiene la confianza del paciente. Dado que una filtración de datos en el sector sanitario puede provocar pérdidas significativas y problemas legales, usar el enmascaramiento de datos es un paso innovador y necesario.
Enfrentando los riesgos de datos en el sector sanitario: ¿por qué Avahi AI es la plataforma adecuada para la seguridad de los datos?
Las organizaciones sanitarias manejan grandes volúmenes de datos confidenciales: historiales de pacientes, detalles de seguros, diagnósticos, etc. Proteger estos datos y mantenerlos utilizables para la prestación de atención, la investigación y las operaciones es un desafío importante.
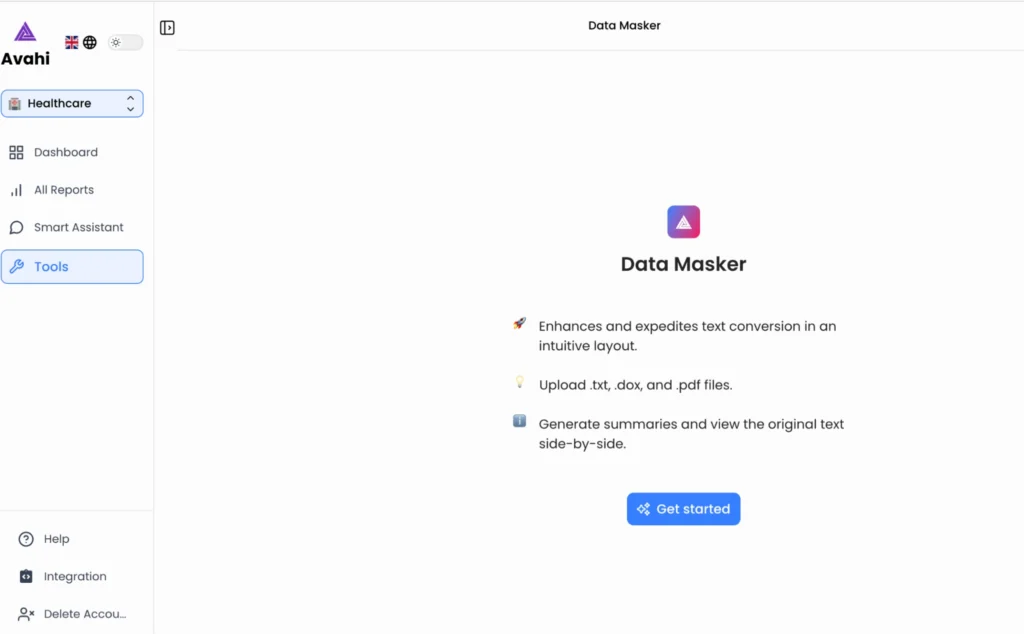
Avahi AI es una plataforma diseñada específicamente que ayuda a los proveedores de atención sanitaria a gestionar, proteger y trabajar con datos de forma más eficiente. Ofrece una potente función de Data Masker diseñada para que la seguridad de los datos sea simple, rápida y efectiva. Por eso es una elección inteligente:
1. Interfaz fácil de usar
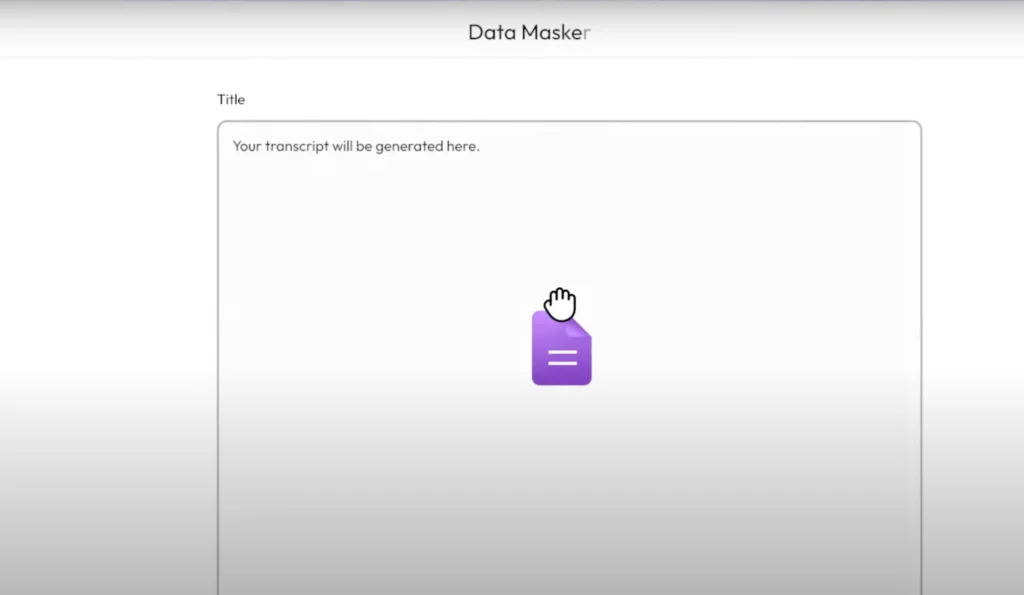
La plataforma cuenta con un diseño claro e intuitivo que no requiere conocimientos técnicos. Los usuarios pueden subir archivos en formatos .txt, .doc o .pdf y procesarlos rápidamente. La configuración es simple, lo que permite que los equipos comiencen sin capacitación adicional ni soporte.
2. Enmascaramiento rápido y preciso
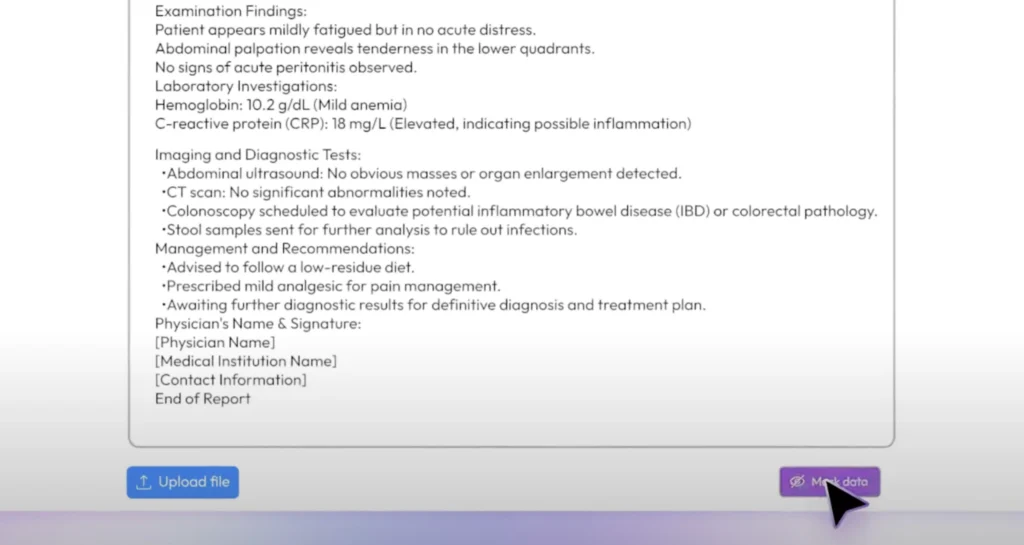
Los datos confidenciales se enmascaran rápidamente y se sustituyen por valores realistas. La herramienta preserva la estructura y el formato originales de los datos, lo cual es esencial para pruebas, entrenamiento o analítica. También mantiene la consistencia semántica, preservando rangos de edad correctos y datos de género, haciendo que el resultado sea significativo.
3. Resumen y vista lado a lado
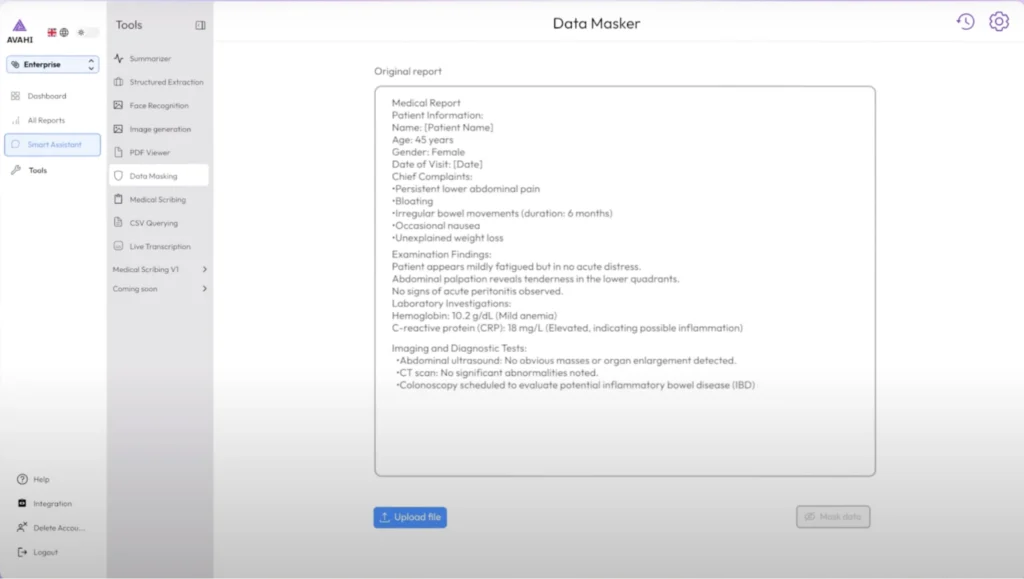
Avahi AI genera automáticamente resúmenes del contenido enmascarado para una comprensión rápida. También permite ver las versiones original y enmascarada lado a lado, lo que facilita verificar resultados y realizar auditorías. Esta función simplifica la validación y reduce el tiempo de revisión manual.
4. Diseñado para casos de uso sanitarios
El Data Masker de Avahi AI está diseñado para manejar información de salud protegida (PHI) e información de identificación personal (PII). Es compatible con estándares clave de cumplimiento como HIPAA, GDPR y otras leyes de privacidad de datos. La herramienta garantiza que los datos enmascarados sigan siendo totalmente utilizables en historiales clínicos electrónicos (HCE) y plataformas de analítica médica.
5. Soporta flujos de trabajo seguros
Data Masker es ideal para entornos no productivos como desarrollo, QA, investigación y entrenamiento. Garantiza que los datos confidenciales nunca queden expuestos, incluso cuando se comparten con equipos externos. Esto ayuda a reducir riesgos durante la migración a la nube o al trabajar con proveedores externos.
6. Ahorra tiempo y recursos
La herramienta reduce el tiempo que los equipos de TI dedican a procesos manuales al automatizar la sanitización de datos. No es necesario crear scripts personalizados, lo que ahorra esfuerzo y recursos. Esto permite que los equipos se enfoquen más en la innovación y menos en los desafíos de cumplimiento.
Al elegir Avahi AI, las organizaciones sanitarias obtienen una plataforma confiable que mejora la seguridad, optimiza la usabilidad de los datos y ayuda a cumplir con los estándares regulatorios, todo mientras ahorra tiempo.
Descubre la plataforma de IA de Avahi en acción
En Avahi, ayudamos a las empresas a implementar IA generativa avanzada que optimiza operaciones, mejora la toma de decisiones y acelera la innovación, todo sin complejidad.
Como tu socio de confianza en consultoría de nube AWS, ayudamos a las organizaciones a aprovechar todo el potencial de la IA, garantizando seguridad, escalabilidad y cumplimiento con soluciones en la nube líderes en la industria.
Nuestras soluciones de IA incluyen
- Adopción e integración de IA – Utiliza Amazon Bedrock y GenAI para mejorar la automatización y la toma de decisiones.
- Desarrollo de IA a medida – Crea aplicaciones inteligentes adaptadas a las necesidades de tu negocio.
- Optimización de modelos de IA – Cambia sin fricciones entre modelos de IA con comparativas automatizadas de costo, precisión y rendimiento.
- Automatización con IA – Automatiza tareas repetitivas y libera tiempo para el crecimiento estratégico.
- Seguridad avanzada y gobernanza de IA – Garantiza cumplimiento, detección de fraude y despliegue de modelos seguro.
¿Quieres desbloquear el poder de la IA con seguridad y eficiencia de nivel empresarial?
¡Empieza con la plataforma de IA de Avahi!
Agenda una llamada de demostración
Preguntas frecuentes
- ¿Qué es el enmascaramiento de datos y cómo protege la información del paciente?
El enmascaramiento de datos sustituye los datos reales del paciente por valores falsos pero realistas, preservando la usabilidad mientras elimina detalles identificables. Incluso si usuarios no autorizados acceden a los datos enmascarados, no pueden rastrearse hasta individuos, lo que lo hace ideal para entornos no productivos como pruebas, entrenamiento y analítica.
- ¿Por qué es importante el enmascaramiento de datos en el cumplimiento sanitario?
El enmascaramiento de datos ayuda a los proveedores de atención sanitaria a cumplir con regulaciones como HIPAA y GDPR al reducir la exposición de información de salud protegida (PHI). Dado que los datos enmascarados se consideran desidentificados, es más seguro usarlos en investigación o sistemas de terceros, reduciendo tanto el riesgo regulatorio como la fricción operativa.
- ¿Dónde se usa el enmascaramiento de datos en entornos sanitarios reales?
Los proveedores de atención sanitaria usan el enmascaramiento de datos durante pruebas de aplicaciones, entrenamiento de modelos de machine learning y migración a la nube. También se aplica para proteger respaldos, entornos de desarrollo y flujos de trabajo de reportes, garantizando que los datos confidenciales permanezcan seguros en todos los puntos de contacto.
- ¿Qué desafíos enfrentan las organizaciones sanitarias con el enmascaramiento de datos?
Implementar el enmascaramiento no siempre es fácil; debe preservar el formato de los datos, mantener la consistencia entre sistemas y funcionar dentro de software heredado. Si no se hace correctamente, el enmascaramiento puede romper flujos de trabajo o distorsionar la analítica. Por eso son esenciales las herramientas específicas para el sector sanitario.
- ¿Cómo ayuda el Data Masker de Avahi AI a que los proveedores de atención sanitaria se mantengan seguros?
Avahi AI ofrece un enmascaramiento rápido que preserva el formato, diseñado para casos de uso sanitarios. Soporta el cumplimiento, mantiene la usabilidad de los datos y simplifica las auditorías con vistas lado a lado y resúmenes automatizados. Está diseñado para mantener la PHI protegida sin ralentizar las operaciones.